Pourquoi le serveur ne peut-il pas simplement dire quels visiteurs ont ajouté un produit au panier ? C’est la question qu’une équipe marketing nous a posée après avoir découvert que Segment n’était alimenté par aucune donnée serveur automatique. La réponse tient en une phrase : un journal d’accès Nginx ou Apache ne connaît rien du comportement applicatif, il ne voit que des requêtes HTTP.
Cette confusion revient régulièrement dans les projets où hébergement et marketing collaborent sans référentiel commun. Voici où se situe réellement la frontière, ce que l’hébergement peut légitimement fournir, et ce qui relève exclusivement de la configuration de Segment côté application, sujet que nous ne traitons volontairement pas ici.
Ce qu’un journal serveur contient réellement
Un access log Nginx classique enregistre une ligne par requête HTTP : adresse IP, méthode, URL demandée, code de statut, taille de la réponse, user-agent. C’est une trace technique du trafic, pas une trace du comportement métier. Une requête POST /panier/ajouter qui retourne un code 200 ne dit rien sur le produit ajouté, le montant, ou l’identité du client connecté.
- Adresse IP et user-agent, sans identifiant de session applicatif fiable
- URL et méthode HTTP, sans le contenu du corps de la requête
- Code de statut, qui ne distingue pas un panier rempli d’un panier vide
- Horodatage précis, souvent la seule donnée réellement exploitable telle quelle
Ce que Segment attend en entrée
Segment fonctionne par événements structurés : Product Added, Order Completed, Checkout Started, chacun accompagné de propriétés (identifiant produit, prix, devise, identifiant utilisateur). Ces événements sont envoyés depuis le code applicatif, au moment précis où l’action métier se produit, via le SDK JavaScript côté client ou une bibliothèque serveur côté back-end.
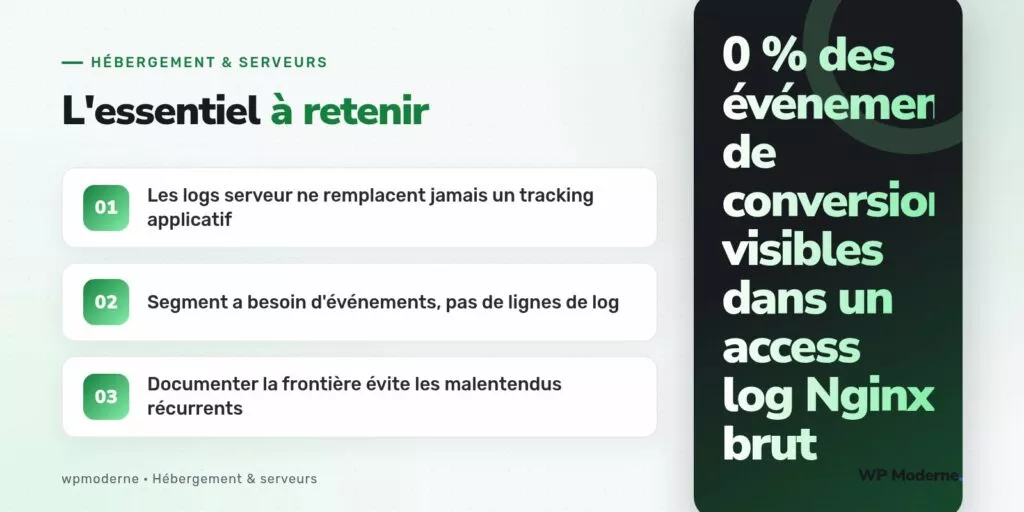
Autrement dit, Segment ne lit jamais de fichier de log. Il reçoit des appels API explicites, déclenchés par du code métier qui sait ce qui vient de se passer. C’est une différence de nature, pas seulement de format : le log est une trace passive, l’événement Segment est une déclaration active.
Où l’hébergement peut légitimement contribuer
Cela ne signifie pas que l’infrastructure serveur n’a aucun rôle. Elle peut fournir des données complémentaires utiles, à condition de rester dans son périmètre : temps de réponse par route, taux d’erreur par endpoint, disponibilité du service à un instant donné. Ces métriques enrichissent une analyse de performance, mais ne remplacent jamais un événement métier.
Exemple de ce qui est raisonnable à demander à l’hébergeur
- Statistiques agrégées de temps de réponse sur les routes de paiement
- Taux d’erreur 5xx sur une période donnée, pour corréler avec une chute de conversion
- Journaux d’accès bruts, à des fins de sécurité, jamais de tracking marketing
La confusion la plus fréquente : identifiant visiteur et adresse IP
Une demande récurrente consiste à vouloir « retrouver le visiteur » à partir de son adresse IP dans les logs serveur, pour le relier à un événement Segment. C’est une fausse piste technique : une adresse IP est partagée par plusieurs visiteurs derrière un même réseau (NAT, proxy d’entreprise, IPv4 partagée en mutualisé), et elle change fréquemment sur mobile. L’identifiant fiable est celui que Segment attribue lui-même via son cookie ou son identifiant anonyme, pas une reconstruction a posteriori depuis les logs.
Quand une demande de tracking ne peut être satisfaite qu’en reconstruisant artificiellement une donnée que l’infrastructure ne possède pas nativement, c’est le signe qu’il faut instrumenter le code, pas complexifier la configuration serveur.
Documenter la frontière pour éviter que la question revienne
La meilleure façon d’éviter ce type de malentendu récurrent est de documenter, dans un référentiel partagé entre équipe technique et équipe marketing, ce que chaque brique du système est censée fournir. Cela évite qu’un ticket urgent atterrisse chez l’hébergeur alors que la correction relève d’une intégration applicative de quelques lignes de JavaScript.
| Besoin exprimé | Réponse appropriée |
|---|---|
| Suivre les conversions par canal | Événement Segment déclenché côté application |
| Diagnostiquer une lenteur du paiement | Métriques serveur (temps de réponse, taux d’erreur) |
| Savoir qui a visité une page | Cookie applicatif, jamais l’IP du log serveur |
Notion à retenir
Un journal serveur documente ce qui a transité sur le réseau ; un événement Segment documente ce qui s’est passé sur le plan métier. Les deux sont complémentaires mais ne se substituent jamais l’un à l’autre. Poser cette distinction dès le départ d’un projet évite des semaines d’allers-retours entre équipes qui, en réalité, ne parlent pas de la même donnée.