Un site d’actualités à très fort trafic, avec plusieurs centaines de milliers de visiteurs quotidiens et un volume de commentaires et de métadonnées considérable, a fini par atteindre un mur que la réplication maître-esclave classique ne suffisait plus à repousser : les écritures, concentrées sur un serveur unique, saturaient régulièrement en période de pic d’actualité, quel que soit le nombre de répliques de lecture ajoutées en parallèle.
Cet article ne revient pas sur la réplication maître-esclave simple, déjà largement documentée par ailleurs. Il détaille l’exploration d’une architecture distribuée inspirée de Vitess, système de gestion de base de données développé initialement par YouTube et devenu projet de la Cloud Native Computing Foundation, appliquée à ce cas précis de WordPress à très fort trafic.
Pourquoi la réplication seule ne suffisait plus
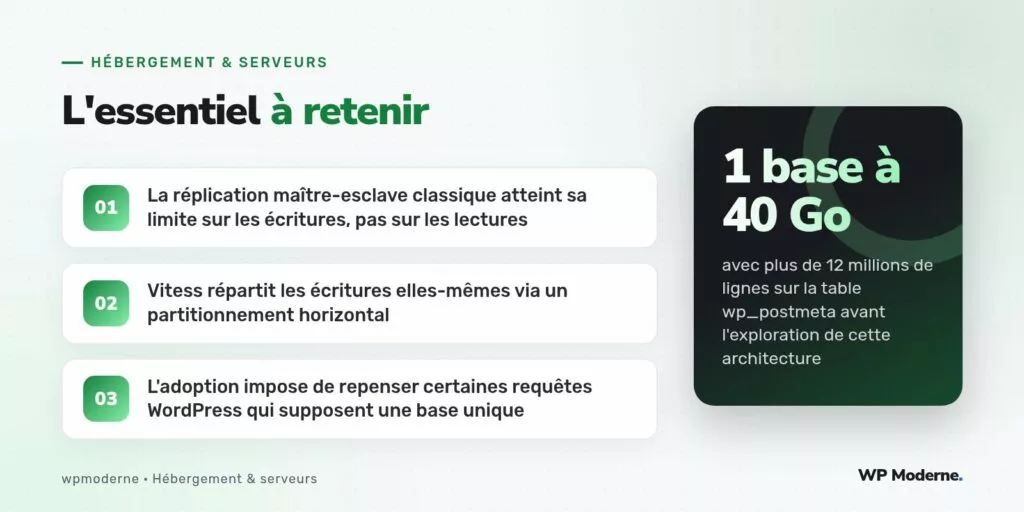
La réplication maître-esclave répartit efficacement la charge de lecture entre plusieurs serveurs, mais toutes les écritures continuent de converger vers un unique serveur maître. Sur ce site, la table wp_postmeta dépassait douze millions de lignes, alimentée en continu par des métadonnées de suivi éditorial, des compteurs de vues personnalisés et des données de personnalisation par article. Chaque pic d’actualité générait un afflux d’écritures concurrentes sur cette même table, créant des verrous et une latence croissante malgré un serveur maître déjà dimensionné largement au-dessus des besoins moyens.
Architecturalement, aucun ajout de réplique de lecture supplémentaire ne pouvait résoudre ce goulot d’étranglement, puisque le problème ne se situait pas du côté des lectures mais bien de la contention en écriture sur un serveur unique.
Le principe du sharding horizontal
Vitess répond à ce problème en partitionnant horizontalement les données : au lieu d’un unique serveur MySQL contenant l’ensemble des lignes d’une table, plusieurs serveurs (appelés shards) contiennent chacun une portion des données, déterminée par une clé de partitionnement. Les écritures se répartissent alors naturellement entre les différents shards plutôt que de converger vers un point unique.
arborescence (simplifiée) :
vtgate (routeur de requêtes)
 ├── shard-0  (post_id 0 à 4 999 999)
 ├── shard-1  (post_id 5 000 000 à 9 999 999)
 └── shard-2  (post_id 10 000 000 à 14 999 999)
      └── réplication maître-esclave interne à chaque shard
Chaque shard conserve une réplication maître-esclave interne classique pour la haute disponibilité de lecture, mais les écritures se répartissent désormais entre les trois maîtres de shard plutôt que de saturer un unique serveur.
Ce que Vitess impose de repenser dans WordPress
L’adoption de cette architecture n’est jamais transparente pour une application comme WordPress, dont le cœur suppose une base de données relationnelle unique. Les requêtes qui joignent des données réparties sur plusieurs shards (par exemple une recherche croisant des articles de différentes plages d’identifiants) deviennent nettement plus coûteuses, Vitess devant alors interroger l’ensemble des shards puis fusionner les résultats côté routeur vtgate.
- Choisir une clé de partitionnement alignée sur le schéma d’accès réel de l’application, ici l’identifiant d’article.
- Identifier en amont les requêtes qui devront croiser plusieurs shards, souvent les recherches globales et certains rapports statistiques.
- Adapter ou mettre en cache ces requêtes transversales, plutôt que de les laisser dégrader la performance de l’ensemble du système.
Un chantier finalement mis en pause
Après une phase d’exploration de plusieurs semaines sur un environnement de test répliquant le volume réel de données, l’équipe a fait le choix de suspendre ce chantier : la complexité opérationnelle introduite par Vitess (gestion des shards, du routeur vtgate, du composant de topologie basé sur etcd ou Consul) dépassait, pour ce cas précis, le bénéfice attendu par rapport à une solution plus modeste : le déplacement des métadonnées les plus volumineuses vers une table dédiée optimisée et l’ajout d’une file d’attente asynchrone pour les écritures non critiques en temps réel, comme les compteurs de vues.
Une architecture distribuée résout un problème de charge, mais en crée un nouveau d’exploitation. Le bon choix n’est pas toujours celui qui règle le goulot d’étranglement le plus vite, c’est celui que l’équipe pourra maintenir dans la durée.
Ce que cette exploration nous a appris
Le déplacement des métadonnées volumineuses et l’introduction d’une file d’attente ont finalement suffi à absorber la charge de pic sans franchir le seuil de complexité qu’aurait imposé Vitess. Ce résultat ne condamne pas l’approche pour tous les cas : sur un site dont l’écriture dépasserait largement ce que ces optimisations plus modestes peuvent absorber, l’architecture distribuée reste une option sérieuse, documentée par le projet lui-même : vitess.io/docs.
Notre verdict
Avant d’envisager une architecture distribuée pour WordPress, épuisez d’abord les optimisations plus simples : externalisation des métadonnées volumineuses, mise en file d’asynchrone des écritures non critiques, et cache applicatif renforcé. Le sharding horizontal reste une solution de dernier recours, justifiée seulement quand ces leviers plus simples ont montré leurs limites.



