df -h affiche 100 % d’utilisation sur /var/www, et le site ne répond plus. Ce scénario, nous l’avons vu se répéter sur plusieurs parcs de sites WordPress, toujours avec la même cause : UpdraftPlus configuré pour sauvegarder chaque nuit, sans jamais purger les anciennes archives, ni les envoyer vers un stockage distant.
Le plugin fait pourtant exactement ce qu’on lui a demandé : sauvegarder. Le problème n’est pas dans l’outil, mais dans une configuration par défaut trop permissive et dans l’absence de supervision de l’espace disque. Voici ce qu’un audit révèle systématiquement, et comment corriger durablement le tir, sans revenir sur les sauvegardes chiffrées vers Backblaze déjà traitées ailleurs sur ce blog.
Ce qu’on observe sur le terrain
Sur un site WordPress de taille moyenne (base de données de 500 Mo, médias de 3 Go), une sauvegarde complète quotidienne sans rotation peut représenter, au bout de six mois, plusieurs dizaines de gigaoctets stockés localement dans wp-content/updraft. UpdraftPlus propose bien un réglage de rétention, mais celui-ci est trop souvent laissé à sa valeur par défaut ou mal compris par la personne qui a installé le plugin.
Le stockage local n’est censé être qu’un tampon avant l’envoi vers une destination distante. Quand cette destination n’est jamais configurée, ou tombe en erreur silencieusement (jeton expiré, quota atteint côté fournisseur), les archives locales s’accumulent indéfiniment jusqu’à saturer la partition.
- Rétention par défaut mal ajustée ou jamais revue depuis l’installation
- Destination distante configurée puis jamais vérifiée dans le temps
- Sauvegardes de médias volumineux dupliquées à chaque exécution complète
- Absence totale d’alerte sur le taux de remplissage du disque
Pourquoi c’est un problème plus grave qu’il n’y paraît
Un disque plein ne se contente pas de bloquer les futures sauvegardes. MySQL peut refuser d’écrire de nouvelles lignes, PHP-FPM peut échouer à écrire ses fichiers temporaires de session, et dans certains cas le système d’exploitation lui-même devient instable si la partition racine est concernée. Un antipattern de sauvegarde devient alors une panne de production complète, alors que l’intention de départ était justement de se prémunir contre la perte de données.
L’ironie est totale : le mécanisme censé protéger le site finit par le mettre hors service. Et comme le disque plein empêche souvent d’écrire les journaux d’erreurs eux-mêmes, le diagnostic initial est plus laborieux qu’il ne devrait l’être.
Corriger la rétention correctement
La première correction consiste à fixer une politique de rétention explicite dans les réglages d’UpdraftPlus : nombre de sauvegardes de base de données à conserver, nombre de sauvegardes de fichiers à conserver, et surtout suppression automatique des anciennes archives une fois l’envoi distant confirmé réussi.
Réglages recommandés pour un site de production
- Conserver 2 sauvegardes complètes maximum en local, jamais plus
- Activer la case « supprimer les fichiers locaux après envoi réussi »
- Séparer la fréquence des sauvegardes de fichiers (hebdomadaire suffit souvent) de celle de la base (quotidienne, plus légère)
Déporter systématiquement les archives
Le disque local d’un serveur de production n’est pas un lieu de conservation fiable pour des sauvegardes : en cas de panne matérielle ou de compromission, sauvegarde et données de production disparaissent ensemble. La destination distante (stockage objet compatible S3, SFTP externe, ou toute autre option prise en charge par le plugin) doit être vérifiée périodiquement, pas seulement configurée une fois puis oubliée.
Un test de restauration trimestriel, même partiel, révèle plus de problèmes de configuration qu’un mois de simple surveillance des logs.
Mettre en place une surveillance qui prévient plutôt que constate
La correction définitive n’est pas seulement de nettoyer le disque une fois, c’est d’empêcher que le problème revienne. Une alerte simple sur le taux d’occupation disque, déclenchée à 80 % puis à 90 %, permet d’intervenir avant la panne plutôt qu’après.
#!/bin/bash
# Alerte simple sur seuil disque, à placer en cron
SEUIL=85
USAGE=$(df --output=pcent /var/www | tail -1 | tr -d ' %')
if [ "$USAGE" -ge "$SEUIL" ]; then
  echo "Disque a ${USAGE}% sur /var/www" | mail -s "Alerte disque" admin@exemple.fr
fi
Ce script rudimentaire suffit largement pour un parc de quelques serveurs ; au-delà, un outil de supervision dédié devient plus adapté, mais le principe reste identique : détecter la tendance avant qu’elle ne devienne une panne.
En résumé
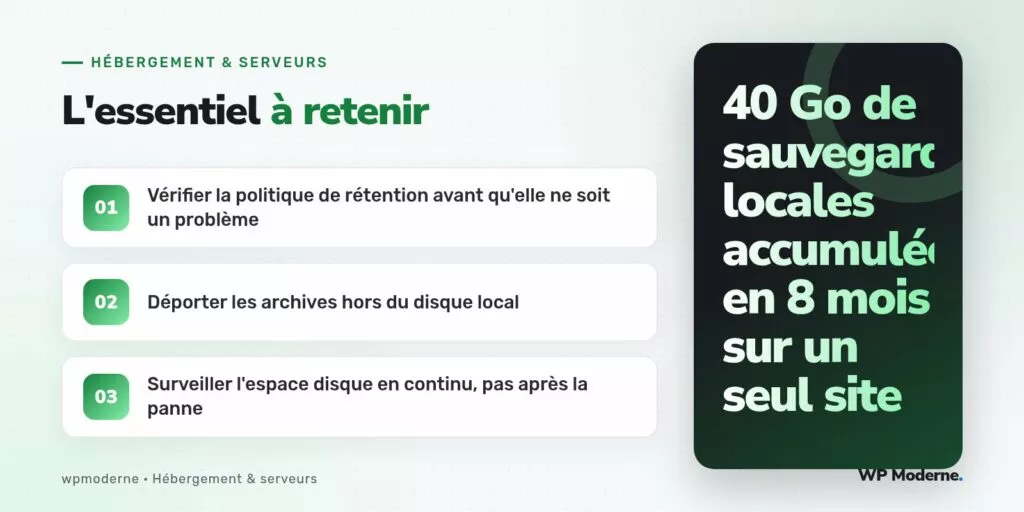
UpdraftPlus n’est pas fautif en soi : c’est l’absence de rétention explicite et de vérification de la destination distante qui transforme un outil de protection en cause de panne. Sur le site que nous avons audité, 40 Go de sauvegardes locales s’étaient accumulées en huit mois sans qu’aucune alerte ne remonte. Une politique de rétention claire, un envoi distant vérifié et une supervision légère de l’espace disque suffisent à éliminer durablement ce risque.