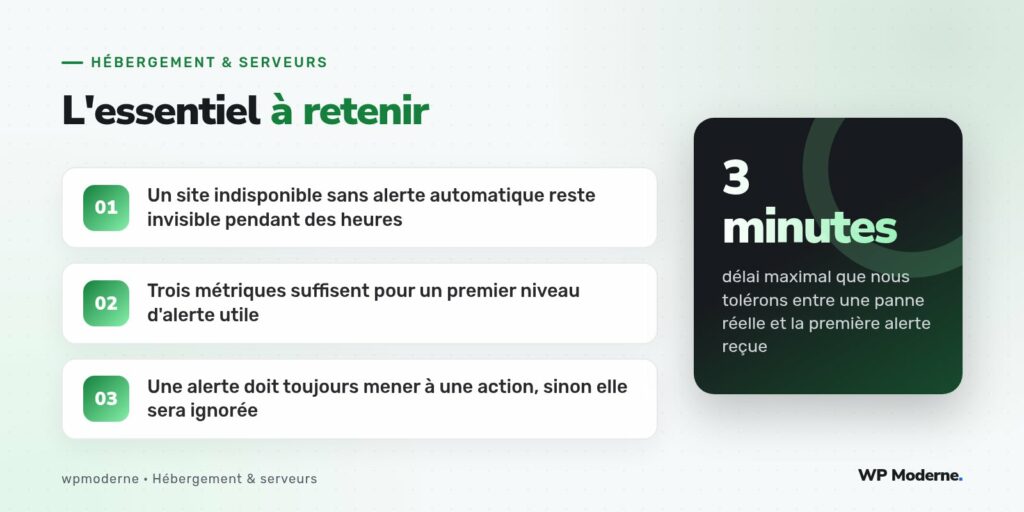
Le pire scénario n’est pas qu’un site tombe en panne — cela arrive, quel que soit le soin apporté à l’infrastructure — mais que personne ne s’en aperçoive avant que le client n’appelle, parfois plusieurs heures après le début de l’incident. À ce stade, la confiance est déjà entamée, même si la panne est résolue en quelques minutes une fois détectée. Une supervision correctement configurée transforme cette découverte tardive en une alerte reçue avant même que le client ne remarque quoi que ce soit.
Mettre en place une supervision utile ne demande pas une infrastructure complexe de type entreprise : trois métriques bien choisies, correctement alertées, couvrent l’essentiel des incidents rencontrés sur un parc de sites WordPress hébergés sur VPS.
La surveillance de disponibilité, le socle minimal
Un test de disponibilité (uptime check) interroge le site à intervalle régulier — typiquement toutes les une à cinq minutes — depuis un serveur externe, et déclenche une alerte si la réponse échoue ou dépasse un seuil de temps de réponse. Des services comme UptimeRobot ou une solution auto-hébergée avec un script cron et une requête curl suffisent à ce premier niveau :
if ! curl -sf -o /dev/null https://exemple.fr; then
    echo "Site injoignable" | mail -s "ALERTE exemple.fr" admin@agence.fr
fi
Ce script minimal, exécuté toutes les minutes via cron, détecte déjà la majorité des pannes complètes. Il ne dit en revanche rien sur la cause : serveur éteint, base de données inaccessible, ou simple lenteur excessive.
Surveiller les ressources du serveur
Un site qui répond encore, mais avec un temps de réponse qui se dégrade progressivement, annonce souvent une panne complète à venir. Surveiller l’utilisation CPU, la mémoire disponible et l’espace disque restant permet d’agir avant la panne plutôt qu’après :
- CPU : une charge soutenue au-delà de la capacité du serveur pendant plusieurs minutes signale un pic de trafic ou un script qui boucle.
- Mémoire : un swap qui se remplit annonce un ralentissement généralisé imminent.
- Disque : un espace disque saturé bloque les sauvegardes, les logs, et peut faire échouer silencieusement des écritures en base de données.
Un outil comme Netdata ou Prometheus associé à Grafana permet de visualiser ces métriques en continu, avec des seuils d’alerte configurables par serveur.
Surveiller les logs d’erreur applicatifs
Au-delà de l’infrastructure, les erreurs PHP journalisées par WordPress lui-même (via WP_DEBUG_LOG) donnent une image complémentaire, plus proche de l’application que du serveur. Un pic soudain d’erreurs fatales après une mise à jour d’extension, par exemple, apparaît d’abord dans ce journal, souvent avant même que les visiteurs ne signalent quoi que ce soit.
tail -f /var/www/exemple.fr/wp-content/debug.log | grep -i 'fatal error'
Une alerte doit toujours mener à une action
Une alerte reçue sans procédure claire pour y répondre finit toujours par être ignorée après quelques faux positifs. Chaque alerte mise en place devrait être accompagnée d’une réponse documentée : qui la reçoit, dans quel délai, et quelle est la première action à entreprendre. Sans cette discipline, la supervision devient un flux de notifications que plus personne ne lit vraiment après quelques semaines.
Une supervision qui génère dix alertes par jour, dont neuf sans conséquence réelle, forme les équipes à les ignorer. Mieux vaut trois alertes fiables qu’une vingtaine bruyantes.
En résumé
La supervision d’un serveur WordPress n’a pas besoin d’être sophistiquée pour être efficace : disponibilité externe, ressources serveur, et logs applicatifs couvrent l’essentiel des incidents réels rencontrés en production. Ce qui compte le plus n’est pas la richesse des outils choisis, mais la certitude qu’une alerte pertinente arrive à la bonne personne, suffisamment tôt pour agir avant que le client ne s’en aperçoive.