Pendant longtemps, notre agence a géré les incidents graves à l’instinct : la personne disponible au moment de la panne improvisait un diagnostic, cherchait les accès dans divers gestionnaires de mots de passe, et reconstituait de mémoire les étapes d’une restauration. Ça fonctionnait, jusqu’au jour où la personne qui connaissait le mieux un serveur précis était en congés au moment d’un incident sérieux. Ce jour-là, le rétablissement a pris quatre heures au lieu d’un délai raisonnable.
Un runbook de reprise après sinistre existe précisément pour retirer l’improvisation de l’équation : un document qui décrit, étape par étape, ce qu’il faut faire, dans quel ordre, et qui en a la responsabilité — écrit à froid, testé en dehors de toute pression, pour être exécutable par n’importe quel membre technique de l’équipe, pas seulement par celui qui a construit le serveur.
Structure générale du document
Notre runbook se découpe en quatre parties distinctes, dans cet ordre précis : la classification de l’incident, les rôles et responsabilités, les procédures de restauration par scénario, et une phase de vérification post-incident. Chaque section répond à une question différente, et mélanger les niveaux (par exemple, débattre des rôles au milieu d’une procédure technique) est précisément ce qui ralentit une intervention sous pression.
runbook-reprise-sinistre/
├── 01-classification/
│   ├── niveaux-de-gravite.md
│   └── criteres-de-declenchement.md
├── 02-roles/
│   ├── incident-manager.md
│   ├── operateur-technique.md
│   └── communication-client.md
├── 03-procedures/
│   ├── serveur-inaccessible.md
│   ├── base-de-donnees-corrompue.md
│   ├── ransomware-suspecte.md
│   └── perte-datacenter.md
└── 04-post-incident/
    ├── verification-integrite.md
    └── retour-experience.md
Classification : tous les incidents ne méritent pas le même traitement
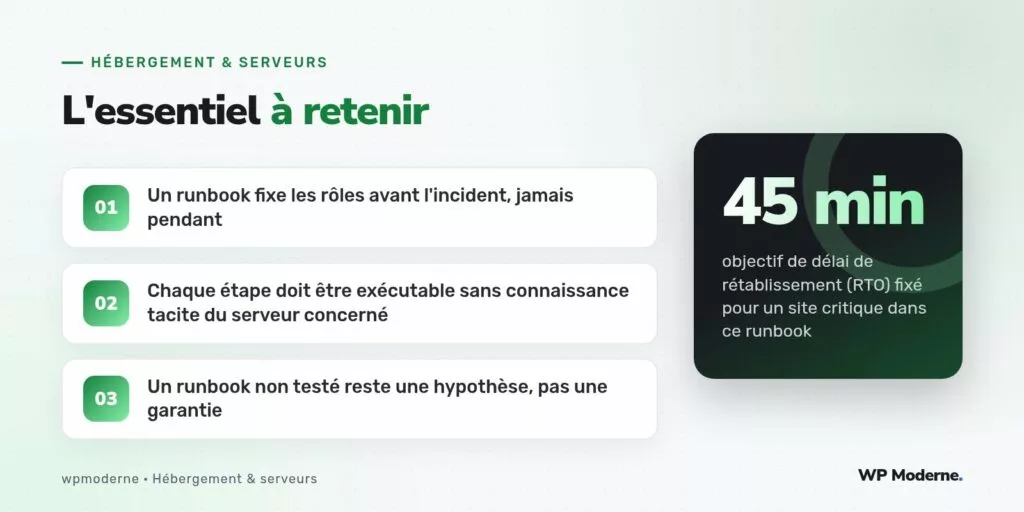
Un site vitrine inaccessible dix minutes un dimanche n’appelle pas la même mobilisation qu’une base de données corrompue sur une boutique en ligne un vendredi après-midi. Le runbook définit trois niveaux de gravité, chacun avec un délai de rétablissement cible (RTO, Recovery Time Objective) et une perte de données maximale tolérée (RPO, Recovery Point Objective) explicitement chiffrés — 45 minutes de RTO et 15 minutes de RPO pour les sites classés critiques, des seuils bien plus larges pour les sites secondaires.
Rôles : qui décide, qui agit, qui parle au client
La confusion des rôles est l’un des pièges les plus fréquents en pleine crise : plusieurs personnes qui tentent la même correction en parallèle, sans coordination, aggravent parfois la situation plutôt que de la résoudre. Le runbook assigne trois rôles distincts dès la déclaration de l’incident : un incident manager qui coordonne et décide, sans toucher lui-même à un serveur ; un ou deux opérateurs techniques qui exécutent les procédures ; une personne dédiée à la communication client, qui rédige des mises à jour régulières sans attendre que la panne soit résolue pour donner signe de vie.
Procédures : des étapes exécutables, pas des intentions
Chaque procédure du dossier 03-procedures est rédigée comme une suite de commandes concrètes à copier-coller, avec le résultat attendu à chaque étape, plutôt que comme une description générale de la démarche. Une phrase comme « vérifier l’état du serveur » ne suffit pas ; le runbook précise la commande exacte, le résultat normal, et l’action à mener si le résultat diffère.
- Chaque procédure commence par les commandes de diagnostic, avant toute action corrective
- Chaque étape corrective précise son effet de bord potentiel, pour éviter une surprise en pleine crise
- Chaque procédure se termine par des critères de vérification explicites du retour à la normale
Vérification post-incident : ne jamais clore sur un simple « ça remarche »
La phase post-incident impose une vérification d’intégrité des données avant de considérer l’incident clos — comparaison de checksums sur les fichiers restaurés, contrôle du nombre de commandes récentes sur une boutique WooCommerce, vérification qu’aucun contenu n’a été perdu dans la fenêtre de restauration. Un retour d’expérience écrit, même bref, suit systématiquement, avec une question simple : qu’est-ce que ce runbook aurait dû prévoir et ne prévoyait pas ?
Un runbook qui n’a jamais été testé en conditions simulées n’est qu’une intention rédigée ; nous en rejouons un scénario chaque trimestre, sur un serveur de test, pour vérifier qu’il tient toujours la route.
Notre verdict
Un runbook n’élimine pas les incidents, il élimine l’improvisation qui les aggrave. Sa valeur ne se mesure pas à sa rédaction, mais à sa mise à l’épreuve régulière : un document qui prend la poussière dans un espace documentaire ne vaut guère mieux que l’absence totale de procédure qu’il était censé remplacer.



