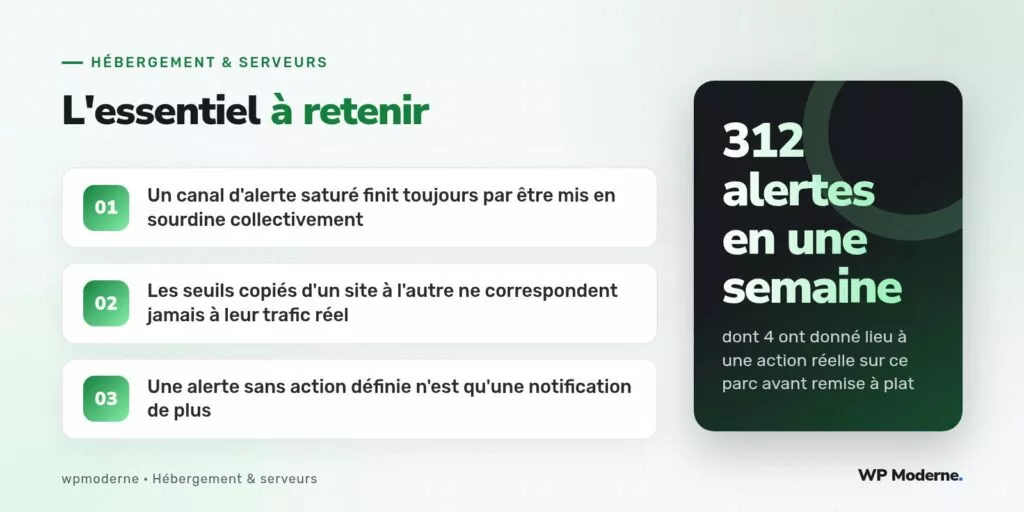
Un nouveau responsable technique rejoint une agence et pose une question simple lors de sa première semaine : pourquoi le canal Slack dédié aux alertes de supervision compte-t-il plus de trois cents messages par semaine, et pourquoi personne ne semble y réagir ? La réponse, en creusant, tenait en un mot : lassitude. Le canal avait été mis en sourdine collectivement des mois auparavant, sans que personne ne l’admette explicitement.
Cet article ne traite pas du choix de l’outil de supervision lui-même, question distincte déjà abordée par ailleurs. Il liste les erreurs classiques de configuration d’alerting qui transforment un système de supervision utile en bruit de fond ignoré, à partir de ce cas réel et de son audit.
Antipattern n°1 : des seuils copiés d’un site à l’autre
Sur ce parc, l’alerte de charge processeur était configurée à un seuil identique de 80 % sur l’ensemble des serveurs, qu’ils hébergent un site vitrine à faible trafic ou une boutique en ligne avec des pics réguliers. Résultat : le site à fort trafic déclenchait une alerte plusieurs fois par jour à chaque pic normal d’activité, tandis qu’un serveur réellement sous-dimensionné pour son usage pouvait rester silencieux tant qu’il ne franchissait pas ce même seuil générique.
Le correctif ne consiste pas à choisir un seuil « moyen » plus adapté, mais à calibrer chaque seuil sur l’historique réel de charge du site concerné, avec une marge cohérente par rapport à ses pics normaux plutôt qu’un chiffre rond appliqué uniformément.
Antipattern n°2 : l’alerte sans action définie
Une part importante des trois cents alertes hebdomadaires concernait des avertissements de type « espace disque à 70 % » sur des serveurs dont l’espace disponible se maintenait en réalité stable depuis des mois, sans tendance à la saturation. Cette alerte ne correspondait à aucune action réelle attendue : personne ne savait s’il fallait purger des fichiers, agrandir le volume, ou simplement ignorer le message.
Une alerte qui ne débouche jamais sur une décision claire — agir maintenant, planifier une action, ou ajuster le seuil car il est mal calibré — finit toujours par être traitée comme du bruit, quelle que soit la gravité théorique du seuil dépassé.
Antipattern n°3 : la duplication de canaux
La même alerte de panne d’un service arrivait simultanément sur trois canaux différents : un email, une notification Slack, et un SMS d’astreinte. Loin de renforcer la fiabilité de la détection, cette duplication a eu l’effet inverse : chaque destinataire supposait qu’un autre canal serait vérifié en priorité par quelqu’un d’autre, une forme de dilution de responsabilité qui a directement retardé le traitement d’un incident réel survenu pendant l’audit.
- Un seul canal doit porter la responsabilité de déclencher une action, les autres restant informatifs.
- L’astreinte doit être nommément assignée à une personne précise, jamais à « l’équipe » en général.
- Un accusé de réception explicite (bouton « je prends en charge ») évite la dilution silencieuse de responsabilité.
Antipattern n°4 : l’absence de hiérarchie de gravité
Sur ce parc, une alerte de latence légèrement dégradée et une alerte d’indisponibilité totale du site arrivaient avec exactement la même mise en forme visuelle et la même urgence apparente. Sans hiérarchie visible entre « à surveiller » et « à traiter immédiatement », l’équipe avait fini par traiter toutes les alertes avec le même degré d’attention — c’est-à-dire, en pratique, aucune.
Antipattern n°5 : jamais de revue périodique des règles
Aucune des règles d’alerting configurées n’avait été revue depuis leur création, certaines datant de plus de trois ans, correspondant à une infrastructure ou un trafic qui n’existaient plus dans leur forme d’origine. Une règle d’alerte configurée un jour donné pour un contexte précis devient obsolète dès que ce contexte change, sans qu’aucune alerte ne signale elle-même son propre vieillissement.
Une supervision qu’on ne révise jamais n’est pas une supervision fiable qui dure : c’est une supervision qui s’éteint lentement sans que personne ne s’en aperçoive.
Ce que la remise à plat a changé
Après cet audit, le nombre d’alertes hebdomadaires est passé de plus de trois cents à une vingtaine, chacune associée à une action définie et un seuil recalibré individuellement par serveur. Le canal Slack, remis en service actif, reçoit désormais des messages auxquels l’équipe réagit systématiquement en moins de dix minutes, un changement de comportement qui n’a rien eu de magique : il découle directement du fait que chaque alerte reçue mérite désormais réellement d’être lue.
Pour aller plus loin
Revoir périodiquement — au minimum une fois par trimestre — l’ensemble des règles d’alerting configurées, en se posant systématiquement la même question pour chacune : si cette alerte se déclenche demain, qui fait quoi, et dans quel délai ? Si la réponse n’est pas immédiate, la règle mérite d’être reformulée ou supprimée.