Chaque reprise de projet commence, chez nous, par un audit d’infrastructure avant même de toucher au code. Sur les vingt dernières reprises, un constat s’est imposé : les mêmes erreurs reviennent, presque toujours dans les mêmes proportions, indépendamment du prestataire précédent ou du secteur d’activité du client. Voici les huit antipatterns les plus fréquents, ce qu’ils provoquent concrètement, et ce que nous corrigeons systématiquement.
Un serveur mutualisé pour un trafic qui l’a dépassé depuis longtemps
Ce qu’on voit : un site qui a grandi sur un hébergement mutualisé choisi au lancement, jamais réévalué depuis, alors que le trafic a été multiplié par dix en trois ans. Pourquoi c’est un problème : les ressources CPU et mémoire partagées bridées provoquent des ralentissements imprévisibles, avec des pics de trafic marketing (une campagne publicitaire réussie) qui tombent le site plutôt que de le faire briller. Quoi faire : migrer vers un VPS dédié dès que le trafic dépasse quelques milliers de visites quotidiennes stables, sans attendre la panne pour agir.
Des sauvegardes stockées sur le même disque que le site
Ce qu’on voit : un dossier /backups à la racine du même serveur, alimenté par un cron quotidien fidèle depuis des années. Pourquoi c’est un problème : en cas de panne disque, de ransomware ou d’erreur d’exploitation touchant le serveur entier, la sauvegarde disparaît avec ce qu’elle était censée protéger. Quoi faire : exporter systématiquement vers un stockage distant indépendant, chiffré, avec une politique de rétention claire et des restaurations testées régulièrement.
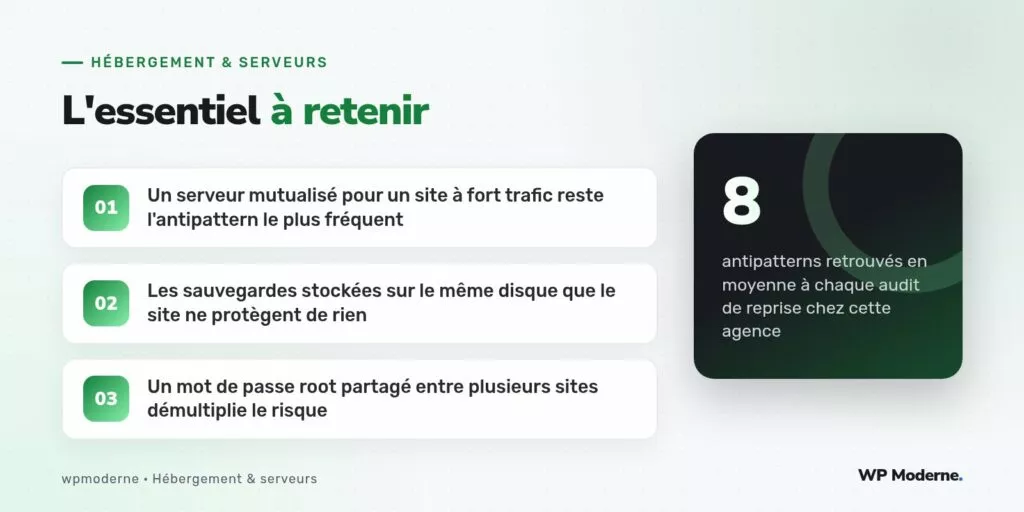
Un compte administrateur unique partagé entre plusieurs personnes
Ce qu’on voit : un identifiant admin unique, mot de passe connu de toute l’équipe et parfois du client lui-même, utilisé aussi bien pour WordPress que pour l’accès SSH du serveur. Pourquoi c’est un problème : impossible de tracer qui a fait quoi en cas d’incident, et la compromission d’une seule personne compromet l’ensemble de l’infrastructure d’un coup. Quoi faire : un compte nominatif par personne, une authentification par clé SSH plutôt que par mot de passe, et une revue régulière des accès actifs.
Aucun certificat TLS renouvelé automatiquement, ou renouvelé sans vérification
Ce qu’on voit : un certificat installé une fois manuellement des années plus tôt, ou une automatisation Certbot jamais vérifiée depuis sa mise en place initiale. Pourquoi c’est un problème : une expiration silencieuse casse la confiance des visiteurs instantanément, avec un avertissement de sécurité plein écran qui fait fuir même le visiteur le plus déterminé. Quoi faire : automatiser le renouvellement et superviser indépendamment la date d’expiration réelle du certificat servi, jamais seulement l’état du service Certbot.
PHP en fin de vie, jamais mis à niveau par crainte de casser un plugin
Ce qu’on voit : des versions PHP 7.2 ou 7.4 encore en production des années après leur fin de vie officielle, faute d’avoir testé la compatibilité des plugins avec une version récente. Pourquoi c’est un problème : l’absence de correctifs de sécurité sur une version en fin de vie expose le serveur à des vulnérabilités connues et documentées publiquement, une cible facile pour des scans automatisés. Quoi faire : planifier une montée de version progressive, testée sur un environnement de staging avant chaque bascule en production.
Aucune séparation entre environnement de test et production
Ce qu’on voit : des mises à jour de plugins testées directement en production, faute d’environnement de staging disponible. Pourquoi c’est un problème : une incompatibilité découverte après coup se répare sous la pression, en public, plutôt qu’en amont dans le calme. Quoi faire : un environnement de staging accessible en quelques minutes, copie fidèle de la production, systématiquement utilisé avant toute mise à jour sensible.
Des identifiants de base de données identiques en développement et en production
Ce qu’on voit : le même mot de passe MySQL utilisé sur l’environnement de développement local d’un ancien prestataire et sur le serveur de production. Pourquoi c’est un problème : un poste de développement compromis (ordinateur volé, malware) donne un accès direct à la base de production. Quoi faire : des identifiants strictement distincts par environnement, régénérés à chaque changement de prestataire.
Aucune supervision au-delà d’un simple ping
Ce qu’on voit : un outil de monitoring qui vérifie seulement que le serveur répond en HTTP, sans surveiller la base de données, le certificat, l’espace disque ou la charge PHP-FPM. Pourquoi c’est un problème : une saturation progressive de l’espace disque ou un pool PHP-FPM sous-dimensionné ne déclenche aucune alerte avant la panne complète. Quoi faire : une supervision multi-couches, du système à l’application, avec des seuils d’alerte fixés avant l’incident.
Une documentation d’infrastructure inexistante ou périmée
Ce qu’on voit : aucun schéma, aucune liste d’accès à jour, une connaissance de l’architecture reposant entièrement sur la mémoire d’une seule personne partie depuis. Pourquoi c’est un problème : chaque reprise de projet recommence une exploration coûteuse en temps, au détriment du client qui paie cette redécouverte. Quoi faire : documenter l’architecture au fil de l’eau, pas en une seule fois à la fin, avec une revue à chaque changement significatif.
Aucun de ces huit antipatterns n’est spectaculaire pris isolément ; c’est leur accumulation silencieuse, année après année, qui transforme une reprise de projet en chantier de remise à niveau complet.
En résumé
Ces erreurs ne relèvent presque jamais de l’incompétence, mais du temps qui manque pour revenir sur des choix pris dans l’urgence au lancement d’un projet. Un audit régulier, même léger, suffit à repérer la plupart de ces antipatterns avant qu’ils ne deviennent le sujet d’une reprise de projet coûteuse.