Last_IO_Error: error connecting to master 'repl@10.20.4.12:3306' - retry-time: 60 retries: 3 message: Connection timed out. Ce message apparaît dans SHOW REPLICA STATUS sur le nœud secondaire d’une réplication MariaDB dont le nœud principal se trouve à plus de neuf mille kilomètres, sur un autre continent. La réplication tourne depuis des mois sans incident, puis se met à casser plusieurs fois par jour, toujours avec ce même message.
Ce cas ne concerne pas une réplication entre deux serveurs proches, dans le même datacenter ou la même région, où un timeout signifie presque toujours une vraie coupure. Sur une liaison intercontinentale, la première question à se poser est différente : le réseau est-il réellement coupé, ou simplement trop lent pour les paramètres actuels ?
Symptôme
Le tableau de supervision montre des cycles réguliers : la réplication fonctionne normalement pendant plusieurs heures, puis le flux IO_THREAD s’arrête avec l’erreur de timeout, redémarre automatiquement grâce à --relay-log-recovery, rattrape son retard, puis recasse quelques heures plus tard. Le nœud secondaire accumule un Seconds_Behind_Master qui grimpe par paliers au lieu de rester stable proche de zéro.
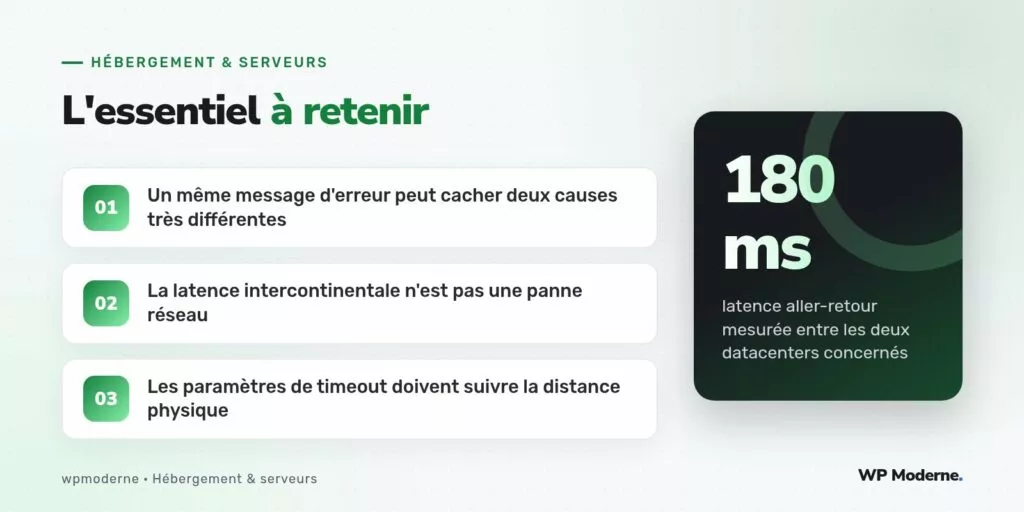
Un premier réflexe consiste à vérifier si le lien réseau entre les deux sites subit des coupures franches. Un relevé continu avec mtr sur plusieurs heures ne montre presque aucune perte de paquets, mais une latence aller-retour qui oscille entre 150 et 220 millisecondes selon l’heure, avec des pics ponctuels dépassant 400 millisecondes aux heures de forte congestion sur les liaisons sous-marines empruntées.
Diagnostic
Le paramètre en cause n’est pas la bande passante mais le délai d’établissement et de maintien de la connexion TCP entre les deux serveurs MariaDB. Deux réglages entrent en jeu :
slave_net_timeout(oureplica_net_timeoutselon la version), qui définit le nombre de secondes sans donnée reçue avant que le thread d’entrées-sorties considère la connexion comme perdue.- Les paramètres TCP keepalive du système d’exploitation, qui peuvent fermer une connexion jugée inactive avant même que MariaDB ne s’en aperçoive.
Sur ce cas précis, slave_net_timeout était resté à sa valeur par défaut de 60 secondes, un réglage pensé pour des liaisons locales où une absence de données pendant une minute est effectivement anormale. Sur une liaison intercontinentale sujette à des pics de latence et à des micro-congestions temporaires des routeurs intermédiaires, ce délai s’avère trop court : une rafale de paquets retardés de quelques secondes suffit à déclencher la coupure.
Un second facteur aggravant est apparu à l’analyse des captures réseau : le pare-feu applicatif situé sur le trajet coupait silencieusement les connexions TCP inactives au-delà de 45 secondes, sans envoyer de paquet RST, ce qui rendait le diagnostic plus difficile puisque rien ne signalait explicitement une coupure côté réseau.
Correctif
La correction a porté sur trois réglages complémentaires, appliqués sur le nœud secondaire :
STOP REPLICA;
SET GLOBAL slave_net_timeout = 180;
CHANGE REPLICATION SOURCE TO
  SOURCE_CONNECT_RETRY = 10,
  SOURCE_RETRY_COUNT = 86400;
START REPLICA;
En complément, l’activation du keepalive TCP applicatif via SOURCE_HEARTBEAT_PERIOD a permis d’envoyer un signal de vie régulier même en l’absence de transactions à répliquer, ce qui empêche le pare-feu intermédiaire de considérer la connexion comme inactive :
CHANGE REPLICATION SOURCE TO
  SOURCE_HEARTBEAT_PERIOD = 20;
Depuis ce changement, le flux de réplication tolère les pics de latence observés sans se couper, et le Seconds_Behind_Master reste stable même pendant les heures de congestion des liaisons internationales.
Prévention
Pour éviter que ce type d’incident ne se reproduise sur une autre paire de datacenters éloignés, plusieurs vérifications valent la peine d’être systématisées avant la mise en production d’une réplication intercontinentale :
- Mesurer la latence aller-retour réelle sur plusieurs jours, à différentes heures, avant de choisir les valeurs de timeout.
- Vérifier la politique de coupure des connexions inactives sur chaque équipement traversé (pare-feu, répartiteur de charge, passerelle VPN).
- Configurer un
SOURCE_HEARTBEAT_PERIODnettement inférieur à tout délai d’inactivité observé sur le trajet. - Surveiller
Seconds_Behind_Masteravec une alerte progressive plutôt qu’un simple seuil binaire, pour détecter une dégradation avant la coupure complète.
Sur une liaison longue distance, un timeout de réplication n’est pas forcément une panne réseau : c’est souvent un paramètre pensé pour le réseau local qu’on a oublié d’ajuster à la géographie réelle de l’infrastructure.
En résumé
Le message Connection timed out dans une réplication MariaDB entre deux continents mérite une lecture différente de la même erreur observée entre deux serveurs voisins. Avant de chercher une coupure réseau, il faut d’abord confronter les paramètres de timeout à la latence réelle du trajet, et vérifier que rien sur le chemin ne referme les connexions jugées inactives. Un réglage de slave_net_timeout et de SOURCE_HEARTBEAT_PERIOD adapté à la distance suffit, dans la majorité des cas, à stabiliser durablement le flux.