Quarante secondes de détection, puis trois minutes vingt de bascule effective : c’est le temps total mesuré lors du dernier exercice de continuité sur un WordPress soumis à une obligation réglementaire de service ininterrompu. Ce chiffre n’a rien d’un objectif théorique inscrit dans un plan de reprise d’activité jamais testé : il vient d’un exercice réel, exécuté en conditions de production, région primaire coupée manuellement pour vérifier que la bascule automatique tient sa promesse.
Ce billet décrit l’architecture qui rend cette bascule possible, pas le choix d’un hébergeur souverain ni les critères de sélection d’un prestataire pour ce type d’obligation, déjà traités par ailleurs. Il s’agit ici de la mécanique technique : comment structurer un WordPress pour qu’une région cloud puisse disparaître sans interrompre le service, et comment vérifier que cette promesse tient dans la durée.
Principe général : actif-passif avec réplication continue
L’architecture retenue repose sur deux régions cloud distinctes, l’une active et l’autre passive, reliées par une réplication continue à trois niveaux : base de données, médias, et configuration applicative. La région passive n’est jamais totalement éteinte : les serveurs applicatifs y tournent en permanence, à capacité réduite, prêts à absorber le trafic dès que la bascule est déclenchée.
région-primaire/
├── lb-frontal (répartiteur de charge)
├── app/ (3 instances PHP-FPM + nginx)
├── mariadb-primaire (source de réplication)
└── stockage-objets (médias, source de synchronisation)

région-secondaire/
├── lb-frontal (en veille chaude)
├── app/ (1 instance PHP-FPM + nginx, capacité réduite)
├── mariadb-replica (réplication semi-synchrone)
└── stockage-objets (réplication continue, lecture seule)

contrôleur-de-bascule/
├── sondes de santé (toutes les 10 s sur chaque région)
├── logique de décision (quorum, pas un seul échec isolé)
└── mise à jour DNS + promotion de la réplique
La réplication de base de données utilise le mode semi-synchrone de MariaDB, qui garantit qu’au moins une transaction est confirmée reçue par la réplique avant que le nœud primaire ne considère l’écriture comme validée côté réplication, réduisant ainsi le risque de perte de données lors d’une bascule brutale.
Le contrôleur de bascule : éviter la décision humaine seule sous pression
Le point le plus fragile de ce genre d’architecture n’est pas la technique de réplication, mais la décision de bascule elle-même. Un incident réel s’accompagne souvent de confusion, et une décision humaine prise dans l’urgence, sans recul, peut aggraver la situation plutôt que la résoudre. C’est pourquoi la bascule ici est pilotée par un contrôleur automatisé qui applique une logique de quorum plutôt qu’un simple seuil.
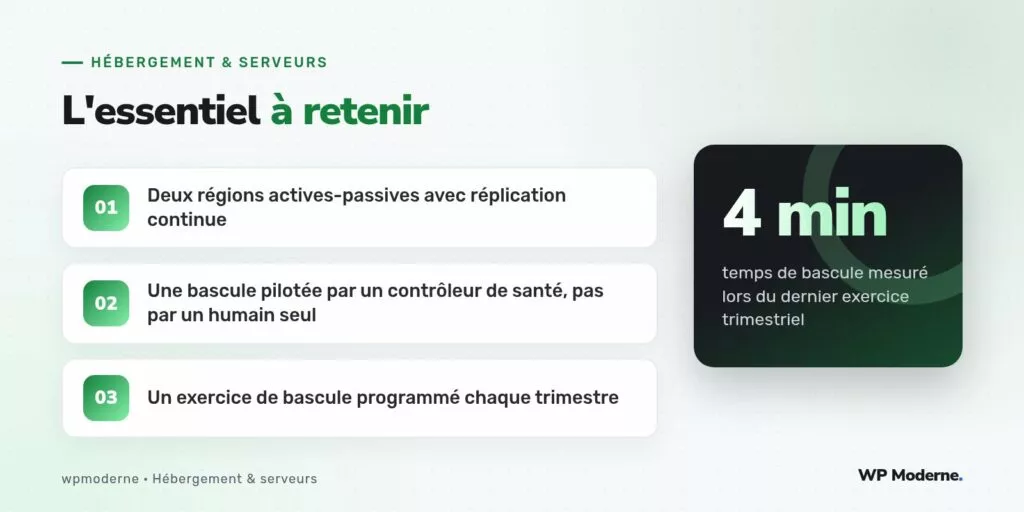
Le contrôleur interroge trois sondes indépendantes toutes les dix secondes : une sonde applicative (réponse HTTP de la page d’accueil), une sonde de base de données (requête de lecture simple sur la réplique) et une sonde réseau (latence et perte de paquets entre les deux régions). La bascule n’est déclenchée que si au moins deux de ces trois sondes signalent une défaillance persistante sur trente secondes consécutives, ce qui évite un basculement intempestif à cause d’un simple pic de latence isolé.
Ce qui se passe concrètement lors d’une bascule
- Le contrôleur détecte la défaillance de quorum sur la région primaire et lance la séquence de bascule.
- La réplique MariaDB de la région secondaire est promue en source d’écriture via
CHANGE REPLICATION SOURCE TO SOURCE_HOST = ''suivi d’un arrêt du rôle de réplique. - Les enregistrements DNS sont mis à jour vers l’adresse IP frontale de la région secondaire, avec un TTL abaissé en amont à 60 secondes pour limiter le délai de propagation.
- Le répartiteur de charge de la région secondaire monte en capacité applicative en réveillant les instances PHP-FPM supplémentaires prévues pour ce scénario.
- Une alerte est envoyée à l’équipe d’astreinte pour confirmation humaine et suivi, mais sans que cette confirmation soit nécessaire au déclenchement initial.
L’exercice trimestriel : la partie qui donne sa valeur au dispositif
Une architecture de bascule qui n’a jamais été testée en conditions réelles reste une hypothèse. L’obligation de continuité qui s’applique ici impose un exercice programmé chaque trimestre, où la région primaire est réellement coupée, sans préavis à l’ensemble de l’équipe, pour vérifier que le contrôleur réagit comme prévu et que la région secondaire absorbe le trafic sans dégradation visible côté utilisateur.
Chaque exercice donne lieu à un rapport qui documente le temps de détection, le temps de bascule, la perte de données éventuelle (mesurée en nombre de transactions non répliquées au moment de la coupure) et tout écart par rapport au comportement attendu. C’est ce rapport, conservé sur plusieurs cycles, qui constitue la preuve de conformité à l’obligation réglementaire de continuité, bien plus qu’un schéma d’architecture jamais éprouvé.
Notre verdict
Une bascule automatique inter-région n’a de valeur que si elle est testée régulièrement, dans des conditions proches de l’incident réel. L’architecture décrite ici repose sur des briques déjà éprouvées individuellement, réplication semi-synchrone, sondes de santé multiples, DNS à TTL court, mais sa fiabilité vient surtout de la discipline de l’exercice trimestriel, qui transforme un plan théorique en un mécanisme dont l’équipe connaît précisément le comportement.