Un client éditeur de contenu technique nous a contactés, perplexe : son site produisait un contenu de référence sur son secteur depuis des années, bien positionné sur Google, mais totalement absent des réponses de ChatGPT et Perplexity, même sur des requêtes où son contenu était manifestement la meilleure source disponible.
Le diagnostic a mis trois jours à aboutir, parce que le blocage ne se trouvait pas là où on le cherche en premier.
Symptôme : une invisibilité totale, pas partielle
Ce qui frappait dans ce cas, c’est le caractère total du silence. Pas une citation occasionnelle, pas une mention indirecte : rien, sur des dizaines de requêtes testées manuellement où le site aurait dû apparaître en bonne place. Ce niveau d’absence suggérait un blocage systématique plutôt qu’un simple manque de popularité.
Diagnostic couche 1 : le fichier robots.txt
Premier réflexe, la vérification du robots.txt. Rien d’anormal à première vue : aucune règle Disallow visant GPTBot, ChatGPT-User ou PerplexityBot. Le fichier autorisait explicitement tous les robots avec un simple User-agent: * / Allow: /. Cette première couche était propre, ce qui a initialement orienté le diagnostic vers une fausse piste — le contenu lui-même.
Diagnostic couche 2 : le pare-feu applicatif du serveur
La deuxième couche a fini par révéler le vrai coupable. L’hébergeur du client avait activé, plusieurs mois auparavant, un pare-feu applicatif (WAF) avec un jeu de règles anti-bot par défaut. Ces règles, pensées pour bloquer le scraping abusif et les robots malveillants, ciblaient les user-agents contenant certains motifs génériques — et le user-agent de GPTBot, qui contient la chaîne GPTBot/1.2, correspondait à une règle de blocage large visant tout ce qui ressemble à un robot d’automatisation non identifié comme moteur de recherche classique.
La vérification s’est faite avec une requête directe simulant le user-agent du robot :
curl -A "Mozilla/5.0 (compatible; GPTBot/1.2; +https://openai.com/gptbot)" \
     -I https://exemple.fr/guide-technique/
La réponse renvoyait un code 403 Forbidden, généré non pas par WordPress mais par la couche réseau de l’hébergeur, en amont complet du CMS — invisible depuis l’administration WordPress, invisible dans les logs applicatifs, visible uniquement dans les logs bruts du pare-feu.
Diagnostic couche 3 : les plugins de sécurité WordPress
Sur d’autres projets, cette même invisibilité provient d’une troisième couche : un plugin de sécurité WordPress configuré pour bloquer les user-agents suspects au niveau applicatif, via des règles similaires à celles d’un WAF mais gérées directement dans l’interface d’administration. Sur ce projet précis, le plugin de sécurité installé n’était pas en cause, mais nous vérifions systématiquement cette couche sur chaque audit, car elle produit exactement le même symptôme.
Correctif : autoriser explicitement, pas juste ne pas bloquer
La résolution a demandé une intervention directe sur la configuration du pare-feu, en dehors de WordPress :
- Ajout d’une règle d’exception explicite pour les user-agents
GPTBot,ChatGPT-User,PerplexityBotetClaudeBotdans la console d’administration du pare-feu. - Vérification que cette exception s’applique avant les règles génériques anti-scraping, l’ordre des règles important particulièrement sur ce type d’outil.
- Nouvelle série de tests avec
curlpour chaque user-agent, confirmant un code200systématique.
Prévention : ce qu’il faut vérifier après chaque changement d’hébergement ou de sécurité
- Tester périodiquement l’accès du site avec les principaux user-agents d’IA générative, pas seulement avec Googlebot.
- Documenter systématiquement l’activation d’un WAF ou d’un plugin de sécurité, avec la liste exacte des règles anti-bot activées par défaut.
- Ne jamais se fier uniquement au
robots.txtpour diagnostiquer un problème de visibilité IA : ce fichier n’est qu’une des trois couches possibles de blocage.
Un robots.txt propre ne garantit rien : le blocage le plus fréquent qu’on rencontre aujourd’hui se cache une couche plus bas, dans une configuration réseau que personne ne pense à vérifier.
En résumé
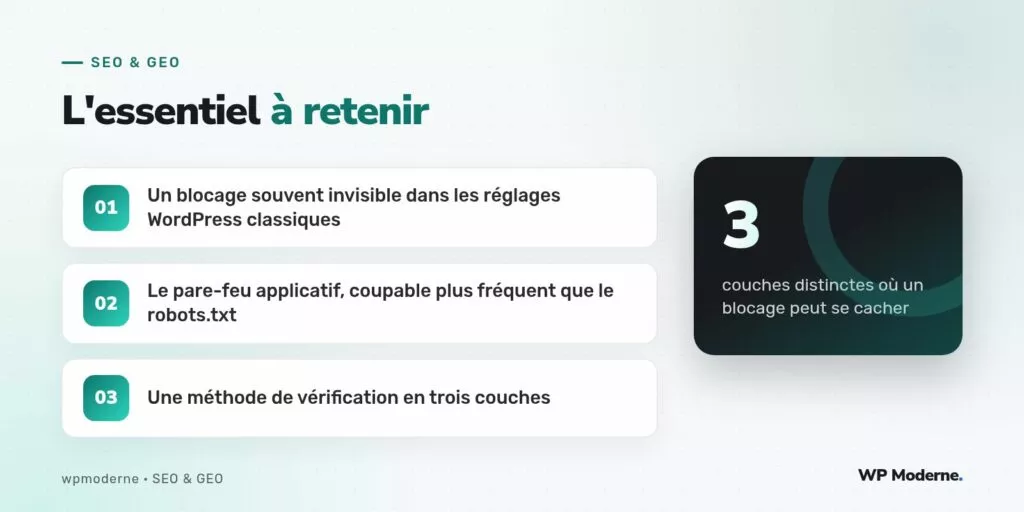
Ce cas rappelle une règle simple mais souvent oubliée : la visibilité auprès des robots d’IA générative dépend de trois couches indépendantes, et chacune peut bloquer silencieusement sans que les deux autres n’en gardent la moindre trace visible. Un diagnostic complet exige de tester chaque couche séparément, avec le user-agent exact du robot concerné, plutôt que de se contenter d’une lecture rapide du fichier le plus visible.