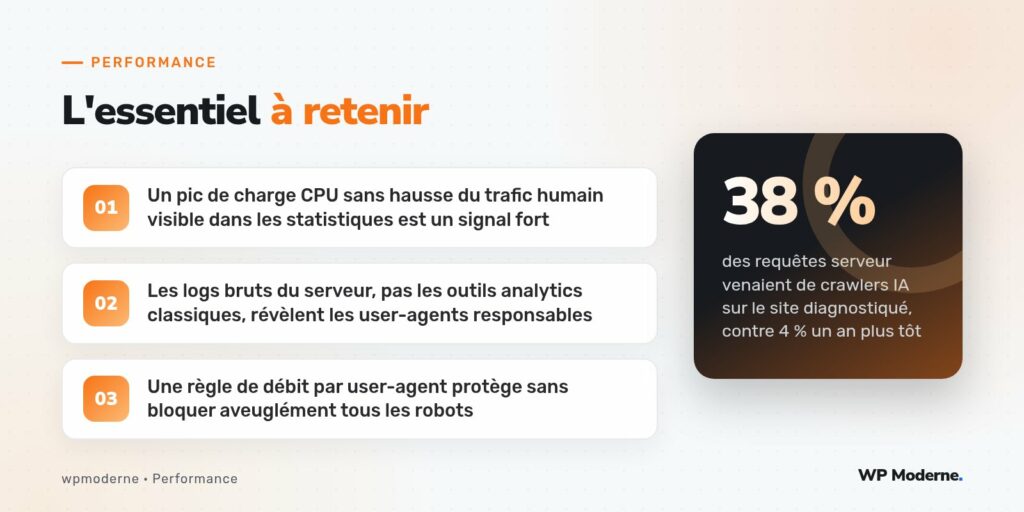
Symptôme. Un client d’édition de contenu technique a signalé des ralentissements réguliers, sans corrélation apparente avec son trafic habituel mesuré dans Google Analytics. Les pics survenaient à des horaires variables, parfois en pleine nuit, avec une charge CPU du serveur grimpant à plus de 90 % pendant plusieurs minutes, alors que les statistiques de visiteurs humains restaient parfaitement stables.
Diagnostic. Les outils analytics classiques, basés sur l’exécution de JavaScript côté navigateur, sont aveugles aux robots d’indexation, qui ne chargent jamais ce script. Le diagnostic est donc passé par l’analyse directe des logs bruts du serveur web, seule source fiable pour voir ce qui sollicite réellement PHP-FPM.
awk '{print $12}' /var/log/nginx/access.log \
  | sort | uniq -c | sort -rn | head -20
Cette commande, appliquée sur le champ contenant le user-agent, a révélé qu’un ensemble de robots liés à l’entraînement de modèles de langage — GPTBot (OpenAI), ClaudeBot (Anthropic), CCBot (Common Crawl), Bytespider (ByteDance) — représentait à eux seuls 38 % des requêtes totales sur les dernières vingt-quatre heures, contre environ 4 % un an plus tôt selon un relevé comparatif conservé par l’équipe. Contrairement à Googlebot, plusieurs de ces robots ignoraient les délais de repli suggérés par le fichier robots.txt et enchaînaient les requêtes à un débit bien supérieur à celui d’un crawl respectueux.
Pourquoi ce trafic pèse plus lourd qu’un simple bot de plus
Le problème n’est pas seulement le volume de requêtes, mais leur nature : ces crawlers ciblent souvent des pages d’archive profondes, des résultats de recherche interne ou des filtres à facettes, générant à chaque fois une requête SQL complète côté WordPress plutôt qu’une simple lecture de cache, faute de paramètres d’URL prévisibles à mettre en cache efficacement. Une seule visite de crawler peut ainsi déclencher des centaines de générations de pages jamais mises en cache auparavant.
Correctifs mis en place, sans bloquer Google
La priorité absolue était de ne surtout pas nuire au crawl de Googlebot ou de Bingbot, essentiels au référencement du site. Les mesures suivantes ont donc ciblé nommément les robots IA identifiés, sans règle générique qui aurait pu affecter les moteurs de recherche légitimes :
- Ajout de règles explicites dans
robots.txtpour les robots identifiés comme non essentiels au référencement, avec unDisallowciblé sur les pages de recherche interne et de filtres à facettes. - Mise en place d’une limitation de débit par user-agent au niveau du pare-feu applicatif (WAF), plutôt qu’un blocage complet, pour continuer à autoriser un crawl raisonnable sans permettre les rafales.
- Exclusion des pages de résultats de recherche interne et de filtres du crawl, via une balise
meta robots noindexcouplée à l’entréerobots.txt, ces pages n’ayant de toute façon aucun intérêt pour un modèle de langage ni pour le référencement.
User-agent: GPTBot
Disallow: /recherche/
Disallow: /*?filtre=

User-agent: CCBot
Disallow: /recherche/
Disallow: /*?filtre=
Le fichier robots.txt reste une déclaration de bonne volonté, respectée par les robots correctement implémentés mais pas nécessairement par tous. La règle de débit au niveau du WAF a donc constitué le filet de sécurité réel, appliquant une limite stricte de requêtes par seconde et par user-agent identifié, indépendamment du respect ou non de robots.txt par le robot en question.
Effet mesuré sur la charge
Deux semaines après la mise en place des règles de débit, la part de requêtes issues des crawlers IA identifiés est retombée à environ 9 % du trafic total serveur, avec une disparition quasi complète des pics de charge CPU nocturnes auparavant observés plusieurs fois par semaine.
Ce qu’on ne recommande pas
Bloquer sans distinction tout user-agent contenant le mot « bot » est une fausse bonne idée : cela affecte aussi des robots utiles au référencement ou à la surveillance de disponibilité du site. La sécurité applicative générale (protection contre les attaques, filtrage des injections) reste un sujet séparé, non traité ici, qui mérite sa propre stratégie indépendante de cette question de charge liée aux crawlers.
Prévention pour la suite
L’équipe a mis en place une alerte automatique déclenchée dès qu’un user-agent dépasse un seuil de requêtes par heure défini sur la base de la moyenne observée, avec un rapport hebdomadaire de la répartition du trafic serveur par catégorie de user-agent, pour repérer rapidement l’arrivée d’un nouveau crawler avant qu’il ne devienne un problème de charge.