Depuis quelques mois, un réflexe s’installe chez des équipes techniques prudentes : dès la mise en ligne d’un nouveau projet, on ajoute par défaut des règles Disallow visant GPTBot, ClaudeBot et consorts dans le robots.txt, souvent en copiant un modèle trouvé sur un forum sans se poser la question de savoir ce que ce blocage empêche réellement.
Ce comportement, qu’on rencontre désormais sur près d’un projet sur cinq lors de nos audits, mérite d’être décortiqué pour ce qu’il est : un antipattern qui prive un site de visibilité GEO sans offrir la protection qu’on croit obtenir en échange.
Ce qu’on voit sur le terrain
Le motif type ressemble à ceci, ajouté sans distinction dans le robots.txt :
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Cette configuration bloque, en une seule fois, l’accès du crawler d’entraînement d’OpenAI, celui d’Anthropic, et l’extension Google dédiée à l’entraînement de ses modèles génératifs. Elle est souvent posée dès le lancement du projet, avant même toute réflexion sur la stratégie de contenu, par un réflexe de précaution qui rappelle celui du blocage systématique des robots inconnus il y a quinze ans.
Pourquoi c’est un problème
Une confusion entre deux usages distincts
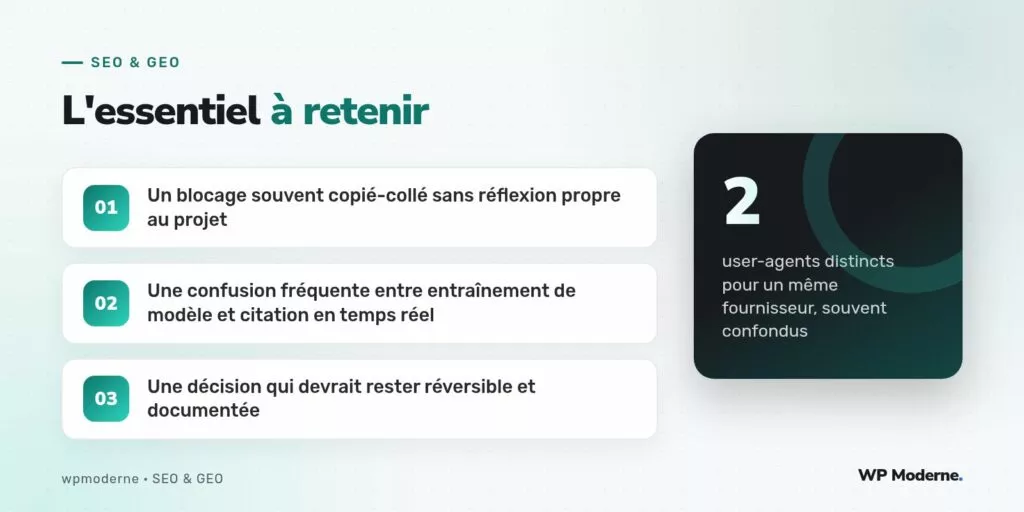
La plupart des fournisseurs distinguent deux familles de robots : ceux qui collectent du contenu pour entraîner un modèle sur le long terme (comme GPTBot ou Google-Extended), et ceux qui accèdent au contenu en temps réel pour construire une réponse à une requête utilisateur précise (comme ChatGPT-User ou PerplexityBot). Bloquer sans distinction ces deux familles revient à couper à la fois l’entraînement futur et la citation immédiate — deux enjeux pourtant très différents, dont un seul relève vraiment d’une question de propriété intellectuelle.
Une perte de visibilité sans contrepartie claire
Un site qui bloque ChatGPT-User ne sera jamais cité dans une réponse ChatGPT construite en temps réel à partir d’une recherche web, même quand son contenu serait la meilleure source disponible sur le sujet posé. Le gain supposé — protéger un contenu de l’entraînement de modèles concurrents — n’a souvent même pas été réfléchi en tant que tel : la règle a été copiée sans distinguer les deux user-agents.
Une décision prise une fois, jamais revue
Sur plusieurs projets audités, le blocage datait de plusieurs mois, posé par un prestataire précédent sans documentation, et personne dans l’équipe actuelle ne savait justifier son maintien. Une décision de blocage qui n’est pas documentée devient, avec le temps, une règle qu’on n’ose plus retirer par prudence, alors même que le contexte qui l’a motivée a disparu.
Quoi faire à la place
- Distinguer explicitement, dans le
robots.txt, les robots d’entraînement des robots de citation en temps réel, et décider séparément pour chacun. - Documenter la décision retenue, avec sa date et sa justification, dans un commentaire du fichier ou dans la documentation technique du projet.
- Réévaluer périodiquement ce choix, à mesure que la politique de citation et d’attribution de chaque fournisseur évolue.
# Autorise la citation en temps réel, bloque l'entraînement de modèle
User-agent: ChatGPT-User
Allow: /

User-agent: GPTBot
Disallow: /
Cette configuration intermédiaire correspond à un choix réfléchi : accepter d’être cité dans une réponse construite en direct, tout en refusant que le contenu serve de matière première à l’entraînement d’un futur modèle. C’est un compromis défendable, à condition qu’il résulte d’une décision explicite et non d’un copier-coller.
Un point de vigilance supplémentaire
Le robots.txt reste une convention respectée volontairement par les acteurs sérieux, pas un mécanisme de blocage technique. Un blocage réel et effectif, si l’objectif est réellement d’empêcher tout accès, demande une règle au niveau du serveur ou du pare-feu applicatif — une distinction que beaucoup d’équipes ignorent encore.
Bloquer par réflexe, c’est décider sans arbitrer. Autoriser en connaissance de cause, même partiellement, reste toujours préférable à un blocage qu’on ne sait plus justifier six mois plus tard.
En résumé
Le blocage systématique des robots d’IA générative dans le robots.txt est devenu un antipattern documenté : il prive un site de sa visibilité GEO sans offrir de protection réelle contre l’entraînement de modèles, faute de distinguer les usages. Une règle réfléchie, documentée et périodiquement revue vaut toujours mieux qu’un copier-coller de précaution posé sans discussion.