Deux mille quatre cents articles signés par le même auteur : c’est le chiffre qui a fait remonter author.php en tête des pages les plus lentes du site lors d’un audit de performance. Le gabarit, hérité d’un vieux thème classique jamais réécrit, exécutait une boucle WordPress classique sur l’ensemble des articles de cet auteur avant d’en afficher seulement les vingt premiers, paginés.
Le problème ne venait pas de la pagination elle-même, déjà correctement gérée par paginate_links, mais de ce que la requête sous-jacente chargeait pour chaque article avant même de savoir s’il serait affiché sur la page courante : contenu complet, métadonnées, taxonomies, tout cela pour des centaines d’articles qui ne seraient jamais rendus sur cette page précise.
Ce que faisait la requête d’origine
Le gabarit s’appuyait sur la boucle WordPress standard, initialisée implicitement par WordPress lui-même à partir de l’URL /author/nom-utilisateur/, sans aucune restriction sur les champs récupérés. Chaque objet WP_Post chargé embarquait son contenu complet, y compris pour les articles situés bien après la page affichée, simplement parce que WordPress calcule le nombre total de résultats en amont pour la pagination.
Sur un auteur avec deux mille quatre cents articles, cette charge se traduisait par un temps de génération de page nettement supérieur à la moyenne du site, visible aussi bien dans les journaux serveur que dans les outils de mesure de performance côté navigateur.
La solution : identifiants d’abord, contenu ensuite
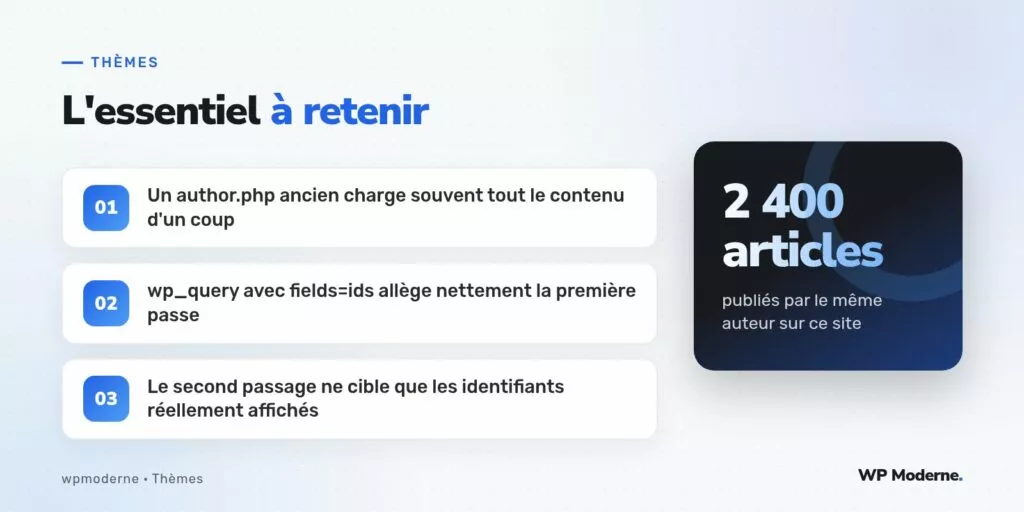
La technique retenue consiste à scinder la requête en deux passages. Le premier ne récupère que les identifiants des articles concernés par la page courante, via le paramètre fields de WP_Query réglé sur ids, ce qui évite à WordPress de charger le contenu complet de chaque article rien que pour compter les résultats et paginer :
$requete_ids = new WP_Query( array(
    'author'         => get_query_var( 'author' ),
    'posts_per_page' => 20,
    'paged'          => get_query_var( 'paged' ),
    'fields'         => 'ids',
    'no_found_rows'  => false,
) );

$ids_page_courante = $requete_ids->posts;
Le second passage cible uniquement ces identifiants précis, avec post__in, pour charger cette fois le contenu complet, mais seulement pour les vingt articles réellement affichés sur la page :
$requete_affichage = new WP_Query( array(
    'post__in'       => $ids_page_courante,
    'orderby'        => 'post__in',
    'posts_per_page' => 20,
) );

while ( $requete_affichage->have_posts() ) {
    $requete_affichage->the_post();
    get_template_part( 'template-parts/carte-article' );
}
wp_reset_postdata();
Le paramètre orderby réglé sur post__in garantit que le second passage respecte l’ordre déjà déterminé par le premier, évitant tout décalage entre les deux requêtes.
Résultat mesuré sur ce site
- Réduction nette du temps de génération de la page d’auteur la plus volumineuse
- Aucune modification visible pour l’utilisateur final, ni dans le rendu ni dans les URL de pagination
- Deux requêtes SQL au lieu d’une seule requête plus lourde, mais un volume de données transférées bien plus faible au total
Ce qui ne fonctionnerait pas partout
Cette technique suppose que le second passage reste raisonnablement rapide, ce qui est le cas ici puisqu’il ne porte que sur vingt identifiants précis. Elle perdrait tout son intérêt sur une page qui afficherait elle-même plusieurs centaines d’articles sans pagination, où le second passage redeviendrait aussi coûteux que la requête d’origine. Sur ce site, la pagination déjà en place à vingt articles par page rendait la technique particulièrement efficace, ce qui ne serait pas garanti sur un gabarit affichant un flux continu sans découpage.
Un autre point à vérifier avant d’appliquer cette technique ailleurs : la présence éventuelle de filtres personnalisés accrochés à pre_get_posts, qui doivent s’appliquer identiquement aux deux passages de requête, sous peine d’obtenir des résultats incohérents entre le comptage des identifiants et l’affichage final du contenu.
Une requête plus légère qui s’exécute deux fois bat souvent une requête unique qui charge tout ce qu’elle n’affichera jamais.
En résumé
Ce correctif n’a nécessité aucune réécriture du thème dans son ensemble, seulement l’ajout d’une étape intermédiaire dans author.php. La technique se généralise à toute page qui liste un grand volume de contenus dans un thème ancien : séparer la détermination des identifiants à afficher du chargement effectif de leur contenu complet reste l’un des gains de performance les plus simples à obtenir sans toucher à l’architecture générale du thème.