Une requête WP_Query standard hydrate systématiquement l’objet WP_Post complet pour chaque résultat — titre, contenu, extrait, métadonnées de base — même quand le bloc appelant n’a besoin que d’un identifiant pour construire un second passage plus ciblé. Sur un bloc de suggestions croisées affichant six offres similaires par fiche, cette hydratation systématique représentait l’essentiel du temps de génération du bloc, un temps qui se répète à chaque fiche consultée.
Le bloc catalogue/offres-similaires, inséré automatiquement en pied de chaque fiche produit d’une plateforme de petites annonces spécialisées, devait d’abord identifier les offres candidates par catégorie et par fourchette de prix, avant d’aller chercher, pour un sous-ensemble restreint, les données réellement affichées — titre, image, prix. Deux besoins distincts, traités jusque-là par une seule requête surchargée.
Le problème posé par une requête classique
La première version du bloc utilisait une requête unique, directement responsable de l’affichage :
$similaires = new WP_Query( array(
    'post_type'      => 'offre',
    'category__in'   => array( $categorie_id ),
    'posts_per_page' => 6,
    'meta_query'     => array( array(
        'key'     => 'prix',
        'value'   => array( $prix_min, $prix_max ),
        'compare' => 'BETWEEN',
        'type'    => 'NUMERIC',
    ) ),
) );
Cette requête charge l’intégralité de chaque objet WP_Post correspondant, y compris le contenu complet de l’annonce — souvent plusieurs paragraphes de description — alors que le bloc n’affiche jamais ce contenu, seulement une vignette résumée.
Séparer identification et enrichissement
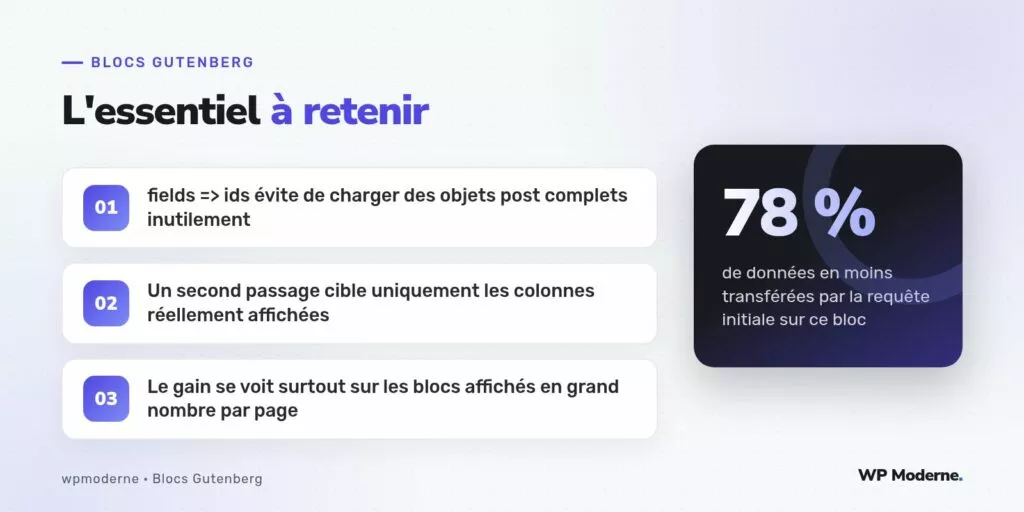
Le paramètre fields de WP_Query, réglé sur ids, indique explicitement à WordPress de ne retourner qu’un tableau d’identifiants, sans hydrater les objets WP_Post correspondants :
$identifiants = get_posts( array(
    'post_type'      => 'offre',
    'category__in'   => array( $categorie_id ),
    'posts_per_page' => 6,
    'fields'         => 'ids',
    'meta_query'     => array( array(
        'key'     => 'prix',
        'value'   => array( $prix_min, $prix_max ),
        'compare' => 'BETWEEN',
        'type'    => 'NUMERIC',
    ) ),
) );
Ce premier passage reste rapide même sur une table de plusieurs dizaines de milliers d’annonces, la clause meta_query restant identique mais l’absence d’hydratation évitant l’essentiel du coût de la requête. Le second passage, lui, cible précisément les colonnes utiles pour l’affichage :
foreach ( $identifiants as $id ) {
    printf(
        '<li><a href="%s">%s</a> — %s €</li>',
        esc_url( get_permalink( $id ) ),
        esc_html( get_the_title( $id ) ),
        esc_html( get_post_meta( $id, 'prix', true ) )
    );
}
Les fonctions get_the_title(), get_permalink() et get_post_meta() s’appuient sur le cache d’objets de WordPress une fois le post préchargé — un appel à _prime_post_caches(), exécuté automatiquement par get_posts() pour son propre tableau d’identifiants, aurait pu compléter le préchargement, mais dans ce cas précis, les métadonnées restaient l’essentiel du coût et un simple accès individuel suffisait.
Mesurer le gain réel
Sur ce projet, la taille des données transférées entre MySQL et PHP pour la requête initiale a chuté de 78 % en passant de l’objet complet à la seule liste d’identifiants — la différence entre transférer une description de plusieurs centaines de mots par annonce et transférer un simple entier. Le gain de temps de traitement, mesuré sur mille exécutions successives du bloc, restait plus modeste mais net : environ 15 % de temps de génération en moins pour ce bloc précis.
| Approche | Données transférées par requête | Usage recommandé |
|---|---|---|
fields par défaut (objets complets) | Élevé | Quand le contenu complet est réellement affiché |
fields => 'ids' | Minimal | Identification suivie d’un accès ciblé aux données utiles |
fields => 'id=>parent' | Faible | Constructions hiérarchiques sans autre donnée nécessaire |
Quand cette optimisation n’apporte rien
Sur un bloc affiché une seule fois par page, avec un petit nombre de résultats, le gain resterait imperceptible pour un visiteur — l’effort de réécriture ne se justifie que lorsque le bloc s’exécute en grand nombre, ou que la table interrogée contient un volume important d’enregistrements. Appliquer systématiquement fields => 'ids' par principe, sans mesure préalable, ajoute de la complexité de code sans bénéfice garanti.
Optimiser une requête avant d’avoir mesuré son coût réel revient à deviner : sur ce projet, seul un passage par le Query Monitor a confirmé que ce bloc précis valait la peine d’être réécrit.
En résumé
Le paramètre fields => 'ids' de WP_Query permet de séparer proprement la phase d’identification des contenus de leur enrichissement, en évitant une hydratation coûteuse quand seul un identifiant est nécessaire dans un premier temps. La mise en cache de ces suggestions, elle, relève d’une autre optimisation, complémentaire mais distincte de celle traitée ici.