'fields' => 'ids' : ce simple paramètre, ajouté à une requête WP_Query, change radicalement la charge de travail imposée à la base de données lorsqu’il s’agit uniquement de vérifier l’existence de contenus avant de décider quoi afficher, sans avoir besoin d’en charger l’intégralité du contenu à ce stade.
Le problème posé par le fallback d’archive
Un gabarit d’archive pour un type de contenu personnalisé doit afficher un fallback lorsque la taxonomie sélectionnée par le visiteur ne contient aucun article publié : plutôt qu’une page vide, un message invitant à consulter d’autres catégories, accompagné d’une liste des taxonomies réellement peuplées. Le premier réflexe consiste à exécuter une requête complète sur chaque taxonomie candidate pour vérifier si elle contient des résultats, ce qui charge inutilement le contenu, les métadonnées et les objets de post complets, alors que seule leur existence compte à ce stade.
Le snippet commenté
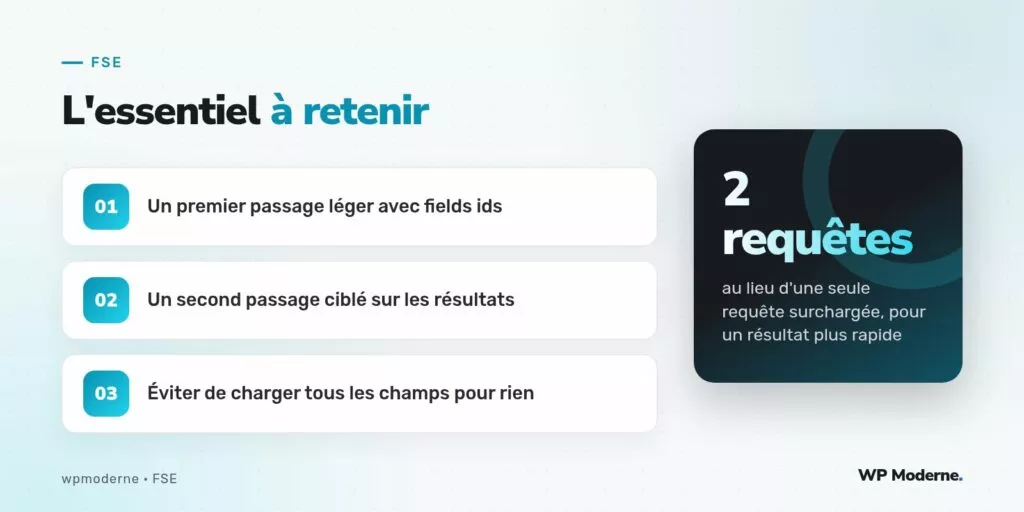
La première requête se limite à récupérer les identifiants, sans charger les objets complets ni leurs métadonnées associées, ce qui réduit fortement la charge sur la base de données pour cette simple vérification préalable :
function trouver_taxonomies_peuplees( array $taxonomies_candidates ) {
    $taxonomies_valides = array();

    foreach ( $taxonomies_candidates as $taxonomie ) {
        $requete = new WP_Query( array(
            'post_type'      => 'ressource_technique',
            'tax_query'      => array(
                array(
                    'taxonomy' => 'categorie_ressource',
                    'field'    => 'slug',
                    'terms'    => $taxonomie,
                ),
            ),
            'fields'         => 'ids',
            'posts_per_page' => 1,
            'no_found_rows'  => true,
        ) );

        if ( $requete->have_posts() ) {
            $taxonomies_valides[] = $taxonomie;
        }
    }

    return $taxonomies_valides;
}
Une fois la ou les taxonomies peuplées identifiées avec ce premier passage léger, un second appel à WP_Query, cette fois sans restriction sur les fields, charge les articles complets nécessaires à l’affichage réel du fallback, uniquement sur la taxonomie confirmée comme pertinente.
$requete_affichage = new WP_Query( array(
    'post_type' => 'ressource_technique',
    'tax_query' => array(
        array(
            'taxonomy' => 'categorie_ressource',
            'field'    => 'slug',
            'terms'    => $taxonomies_valides[0],
        ),
    ),
    'posts_per_page' => 6,
) );
Pourquoi ce découpage en deux passages est plus rapide
Le paramètre no_found_rows, combiné à fields => ids, évite à MySQL de calculer le nombre total de résultats et de charger les colonnes complètes de la table wp_posts pour une requête dont le seul objectif est de savoir si au moins un résultat existe. Sur un site avec plusieurs dizaines de taxonomies candidates à vérifier en cascade, cette optimisation réduit sensiblement le temps de réponse du gabarit de fallback.
Variantes utiles
- Mettre en cache le résultat de la vérification des taxonomies peuplées via un transient à courte durée de vie, pour éviter de répéter ce premier passage à chaque chargement de page.
- Combiner cette technique avec
WP_Query::get_posts()plutôt quehave_posts()lorsque la liste complète des identifiants doit être réutilisée directement, sans boucle supplémentaire. - Adapter le nombre de taxonomies testées en cascade selon la fréquence à laquelle de nouvelles ressources sont publiées, pour éviter de vérifier inutilement des taxonomies historiquement toujours vides.
Une requête qui ne sert qu’à vérifier une existence ne devrait jamais charger plus que ce dont elle a réellement besoin : c’est souvent là que se cache la marge de performance la plus simple à obtenir.
Ce que cette technique ne couvre pas
La mise en cache du résultat final du fallback, une fois affiché, reste un sujet distinct qui relève de la stratégie de cache globale du site plutôt que de l’optimisation de cette requête précise. Cette recette se limite à réduire le coût de la vérification préalable, pas à éviter de la répéter à chaque visite.
En résumé
Séparer la vérification d’existence, allégée avec fields => ids et no_found_rows, du chargement effectif des articles à afficher, permet d’accélérer sensiblement un fallback d’archive sans changer sa logique fonctionnelle. Ce découpage en deux passages reste une des optimisations les plus simples à appliquer sur une Query Loop existante, sans réécriture profonde du gabarit.