Un client nous a transmis ses logs serveur avec une question simple : pourquoi Googlebot continue-t-il de frapper à la porte de pages supprimées depuis plus d’un an ? Le site avait migré sa taxonomie de produits en 2022, remplacé 1 800 URL obsolètes par des réponses HTTP 410 Gone, et pourtant les journaux d’accès montraient encore, en octobre 2023, des centaines de requêtes quotidiennes sur ces mêmes chemins.
Ce n’est pas un bug de Google. C’est un comportement documenté, mais mal compris, qui mérite qu’on déroule le fil du diagnostic jusqu’au correctif.
Symptôme : un crawl qui ne s’arrête jamais
Dans la Search Console, l’onglet Pages affichait ces URL sous « Introuvable (404) » — pas 410, ce qui est le premier indice à ne pas ignorer. Le rapport de couverture ne distingue pas toujours les deux codes dans son libellé, mais l’export brut de l’API confirmait bien un code retour 410 exact, servi par le serveur d’origine, vérifié avec curl -I.
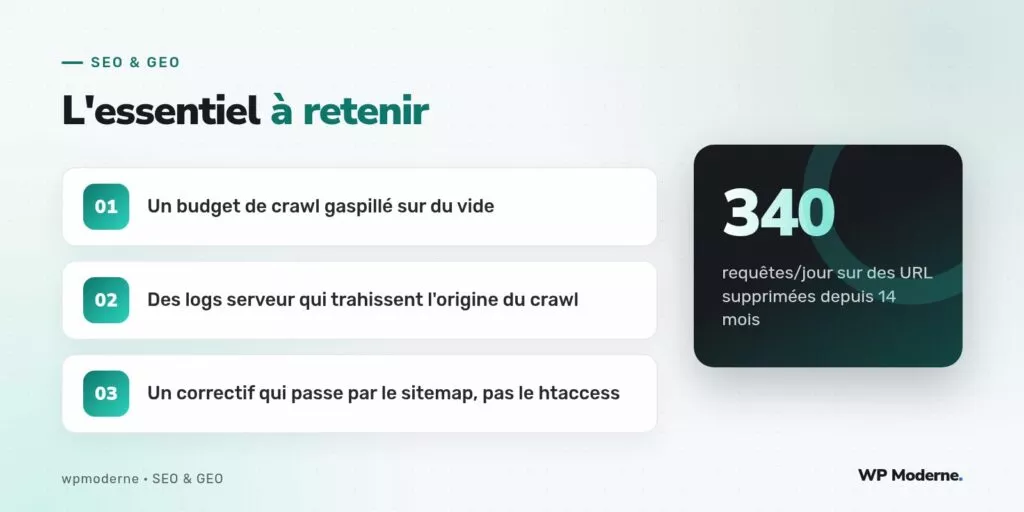
- 340 requêtes par jour en moyenne sur les 1 800 URL concernées, quatorze mois après la suppression.
- Le user-agent était systématiquement Googlebot, jamais un crawler tiers.
- Aucune de ces URL n’apparaissait plus dans le sitemap XML depuis la migration.
Diagnostic : pourquoi Google s’obstine
Google traite le 410 comme un signal plus fort que le 404 pour accélérer la désindexation, mais « plus fort » ne veut pas dire « immédiat ». Le moteur conserve une liste d’URL connues issue de son historique de crawl, des backlinks externes et des anciens sitemaps, et il revient périodiquement vérifier qu’un statut ne change pas — exactement comme il le ferait pour confirmer qu’une redirection temporaire ne redevient pas permanente.
Trois facteurs expliquaient la persistance dans ce dossier précis :
Des liens externes toujours actifs
Un annuaire professionnel et deux partenaires B2B pointaient encore vers l’ancienne arborescence produits. Tant qu’un lien externe existe, Googlebot a une raison de revisiter l’URL, même en 410, ne serait-ce que pour vérifier l’état du lien pour ses propres calculs de graphe.
Un ancien sitemap resté accessible
Le sitemap généré par l’ancien thème n’avait jamais été supprimé du serveur. Il traînait à /sitemap-produits-old.xml, invisible dans la navigation mais toujours référencé dans un fichier robots.txt archivé par la Wayback Machine, que Google consulte parfois pour retrouver d’anciennes structures.
Une fréquence de crawl historiquement élevée
Ces pages produits recevaient énormément de trafic avant leur suppression. Le budget de crawl alloué par Google à un site est en partie hérité du comportement passé : une zone très explorée met plus de temps à voir sa fréquence de visite redescendre, même quand le contenu a disparu.
Correctif : fermer les portes une par une
La suppression pure et simple ne suffisait pas ; il fallait couper les sources qui réalimentaient le crawl.
- Suppression physique du fichier
sitemap-produits-old.xmlet de sa mention dansrobots.txt. - Contact des deux partenaires B2B pour mise à jour de leurs liens vers les nouvelles fiches produits.
- Ajout d’un en-tête
Cache-Control: no-storesur les réponses 410, pour éviter qu’un proxy intermédiaire ne serve une version mise en cache plus ancienne. - Vérification via l’outil d’inspection d’URL de la Search Console, en demandant une nouvelle exploration groupée sur un échantillon de 50 URL représentatives.
Six semaines après ces actions, le volume de requêtes quotidiennes sur les URL en 410 était tombé à 22, contre 340 au départ. La courbe ne tombe jamais à zéro instantanément : Google conserve une trace de vérification à très basse fréquence, parfois pendant des années, pour des URL qui ont compté.
Prévention : ce qu’on aurait dû faire dès la migration
Le vrai enseignement de ce cas n’est pas le correctif, c’est l’anticipation manquée. Trois réflexes auraient évité la moitié du problème :
- Auditer tous les sitemaps historiques présents sur le serveur avant une migration, y compris ceux générés par un plugin désinstallé.
- Vérifier les backlinks entrants sur les URL condamnées avant de les couper, via la Search Console ou un outil de netlinking, pour prioriser les demandes de mise à jour.
- Ne jamais laisser un fichier robots.txt archivé continuer de pointer vers des ressources obsolètes ; un simple grep sur les logs d’accès révèle vite ce genre d’ornière.
Un code 410 n’est pas un mur, c’est une porte qui se ferme lentement. Tant qu’un lien externe ou un vieux sitemap la maintient entrouverte, le crawler continuera de pousser dessus.
En résumé
Un crawl résiduel sur des pages en 410 n’est presque jamais un problème de code HTTP mal configuré. C’est un problème de traces : sitemaps oubliés, liens externes non nettoyés, historique de crawl hérité. Le 410 reste le signal le plus rapide pour faire comprendre à Google qu’une ressource a définitivement disparu, mais « rapide » se mesure ici en semaines, pas en heures, et seulement si toutes les portes dérobées sont fermées en même temps.