Une agence spécialisée dans les sites à fort trafic m’a confié la conception d’une architecture headless pour un client media, avec WordPress cantonné au rôle de back-office de contenu et un frontend Next.js entièrement découplé consommant les données via WPGraphQL. Le rendu côté serveur d’un thème classique, traité dans un article distinct, ne suffit pas ici : il s’agit d’une architecture entièrement différente, où WordPress ne sert plus jamais de HTML directement au visiteur final.
Le piège initial du headless mal préparé
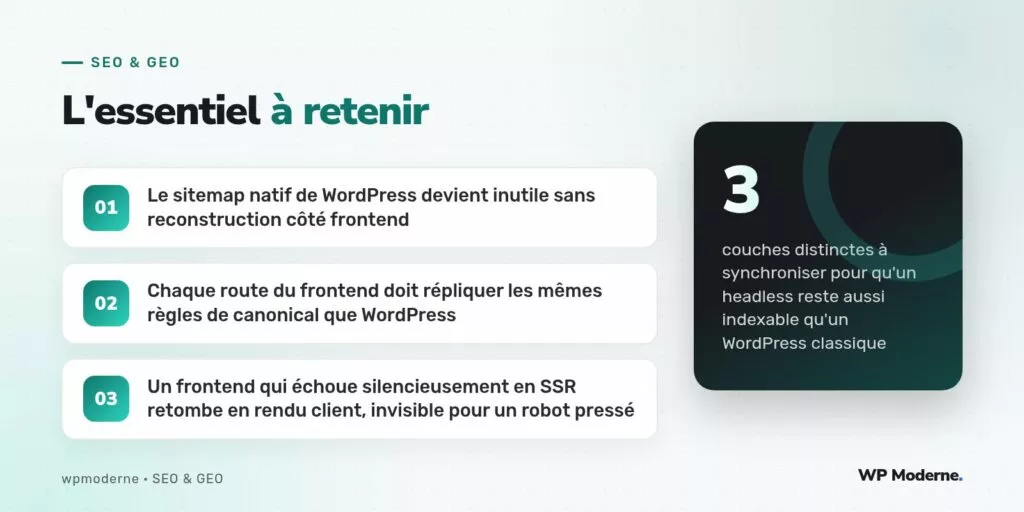
Le premier prototype construit par l’équipe de développement, focalisé sur la vitesse de livraison, avait tout simplement oublié trois éléments que WordPress gère nativement mais qui n’existent plus une fois le frontend découplé : le sitemap XML, les redirections gérées par les extensions SEO habituelles, et la balise canonique générée automatiquement par le thème. Rien de tout cela n’existe par défaut côté Next.js : chaque brique doit être reconstruite explicitement.
L’arborescence retenue
media-headless/
├── wordpress/                  (back-office, API GraphQL uniquement)
│   ├── wp-content/plugins/wp-graphql/
│   ├── wp-content/plugins/wp-graphql-yoast-seo/
│   └── wp-content/mu-plugins/api-sitemap-proxy.php
├── frontend/                   (Next.js, rendu hybride)
│   ├── app/[slug]/page.tsx     (rendu SSG avec revalidation)
│   ├── app/sitemap.xml/route.ts
│   ├── app/robots.txt/route.ts
│   └── middleware.ts           (redirections synchronisées)
└── worker-sync/                (tâche planifiée de synchronisation)
    └── verifier-canonicals.js
Couche 1 : le sitemap reconstruit côté frontend
Le sitemap n’est plus généré par WordPress mais par une route dédiée du frontend, alimentée par une requête GraphQL paginée qui interroge WPGraphQL pour la liste complète des articles et de leur date de modification :
export async function GET() {
  const { data } = await client.query({ query: TOUS_LES_ARTICLES });
  const urls = data.posts.nodes.map(
    (p) => `<url><loc>https://exemple.fr/${p.slug}</loc><lastmod>${p.modified}</lastmod></url>`
  );
  return new Response(
    `<?xml version="1.0" encoding="UTF-8"?><urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">${urls.join('')}</urlset>`,
    { headers: { 'Content-Type': 'application/xml' } }
  );
}
Couche 2 : les redirections synchronisées, pas dupliquées
Plutôt que de gérer les redirections dans deux systèmes différents (l’extension SEO côté WordPress et un fichier de configuration côté frontend), un choix a été fait pour une source de vérité unique : les redirections restent saisies par l’équipe éditoriale dans WordPress, exposées via un point de terminaison REST personnalisé, et synchronisées vers le middleware Next.js toutes les dix minutes par une tâche planifiée.
Couche 3 : le canonical répliqué à l’identique
La balise canonique générée par l’extension SEO côté WordPress (récupérée via wpseo_head_json exposé en GraphQL) doit être reprise sans transformation côté frontend, dans la balise <head> générée par Next.js, pour éviter tout écart entre ce que l’éditrice croit avoir configuré et ce qui est réellement servi au moteur.
Sur ce projet, un script de vérification quotidien compare automatiquement le canonical attendu (récupéré via l’API WordPress) et le canonical réellement présent dans le HTML servi par le frontend en production, avec alerte en cas d’écart.
Le point de vigilance sur le rendu
Un rendu statique généré à la publication (SSG avec revalidation incrémentale) plutôt qu’un rendu entièrement côté client garantit qu’un robot reçoit toujours du HTML complet dès la première requête, sans dépendre de l’exécution de JavaScript ni d’une file d’attente de rendu différé.
En résumé
Une architecture WordPress headless ne perd sa capacité de découverte par les moteurs que si personne ne reconstruit explicitement ce que le cœur de WordPress gérait auparavant en silence : sitemap, redirections et canonical doivent chacun trouver leur nouvelle source de vérité, avec une synchronisation vérifiée plutôt que supposée entre le back-office et le frontend.