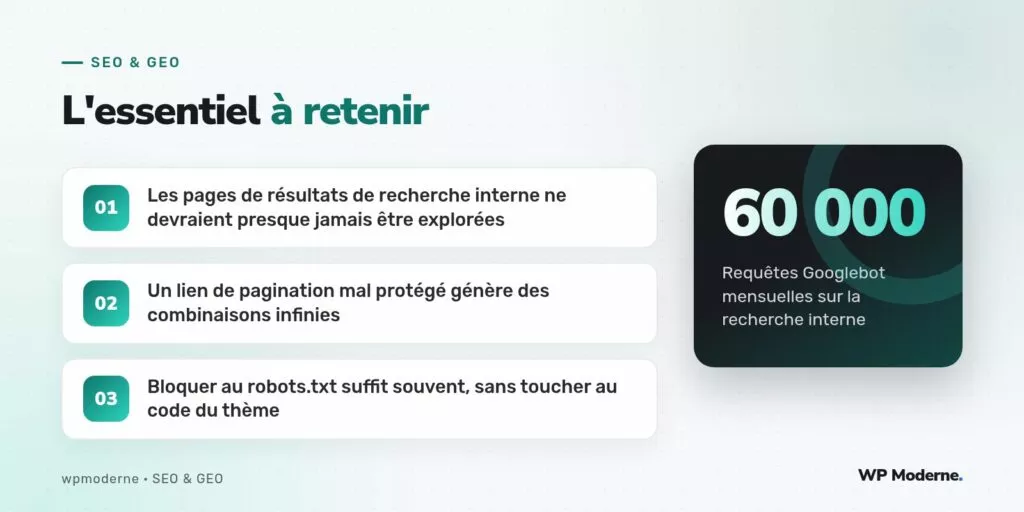
Une agence gère un site catalogue de 4 000 références, avec un moteur de recherche interne assez permissif : chaque combinaison de mots tapés par un visiteur génère une URL du type /?s=motclef, indexable par défaut. En analysant les logs serveur du mois précédent pour un client, un chiffre a sauté aux yeux : plus de 60 000 requêtes de Googlebot sur des URL de recherche interne, pour un site qui ne compte que 4 000 pages de contenu réel.
Ce genre de gaspillage passe souvent inaperçu parce qu’aucune de ces pages ne génère d’erreur : elles répondent toutes en 200, avec un contenu généré normalement. Le problème n’est pas visible dans Search Console au premier coup d’œil, il faut aller le chercher dans les journaux du serveur.
Comprendre pourquoi ces pages explosent en nombre
Le moteur de recherche natif de WordPress, basé sur la variable de requête s, accepte n’importe quelle chaîne de caractères en paramètre d’URL. Si le thème affiche un lien « recherches associées » ou une pagination de résultats, chaque variation de terme, chaque combinaison avec un filtre de catégorie, crée une URL techniquement unique. Un robot qui explore une page de résultats trouve des liens vers d’autres pages de résultats, et le phénomène s’auto-alimente : c’est un piège à budget de crawl classique.
Vérifier l’ampleur réelle avec les logs
Avant d’agir, il faut mesurer. Une commande simple sur les logs d’accès permet de quantifier le phénomène pour Googlebot spécifiquement :
grep "Googlebot" access.log | grep "/?s=" | wc -l
Sur le cas traité, cette commande a confirmé le chiffre observé dans l’échantillon initial, en l’étendant à trois mois de logs complets : la proportion de requêtes de Googlebot consacrée aux pages de recherche interne dépassait 40 % du budget de crawl total du site, largement au-dessus de ce que représentait le contenu utile du catalogue.
Bloquer proprement sans casser l’expérience utilisateur
La correction ne doit pas empêcher les visiteurs humains d’utiliser la recherche : elle doit seulement empêcher les robots de l’explorer et de l’indexer. Deux leviers complémentaires, à combiner :
- Ajouter une règle dans le
robots.txtpour empêcher l’exploration :Disallow: /?s=, qui coupe court à toute visite de Googlebot sur ces URL. - Poser une balise
noindexsur le template de résultats de recherche viais_search(), en complément, pour les cas où une URL de recherche serait déjà indexée avant la mise en place du blocage.
Ces deux mesures ne sont pas redondantes : le Disallow empêche l’exploration future, tandis que la balise noindex permet à Google de désindexer les URL déjà connues, à condition qu’elles restent explorables le temps que Google relise la balise. Il faut donc temporairement autoriser l’exploration des URL déjà indexées, le temps qu’elles disparaissent, avant de généraliser le blocage complet.
Traiter le cas des filtres combinés à la recherche
Sur ce site catalogue, la recherche se combinait aussi à un filtre de catégorie via un second paramètre, ce qui démultipliait encore les URL uniques. Le blocage du seul paramètre s ne suffisait pas : il fallait une règle plus large couvrant toute combinaison où s apparaît, quel que soit l’ordre des paramètres dans l’URL. Un test avec l’outil d’inspection d’URL de Search Console a permis de confirmer que Disallow: /?s= couvre bien les URL où s est le premier paramètre, ce qui représentait la quasi-totalité des cas réels observés dans les logs.
Mesurer l’effet après correction
Trois semaines après la mise en place des deux mesures, une nouvelle extraction de logs a montré une chute de la part du budget de crawl consacrée aux pages de recherche, passant de 40 % à moins de 5 %. Le nombre de pages de contenu réel explorées quotidiennement par Googlebot, lui, a augmenté sensiblement sur la même période, signe que le budget libéré a été redirigé vers des pages qui comptent réellement pour le référencement du client.
Sur un site avec une recherche interne active, je vérifie systématiquement les logs avant de conclure qu’un problème de budget de crawl vient forcément de la taille du catalogue : la cause est souvent ailleurs, et bien plus facile à corriger.
Bilan de l’intervention
Le budget de crawl n’est pas un concept abstrait réservé aux très gros sites : dès quelques milliers de pages, un moteur de recherche interne mal protégé peut consommer une part disproportionnée de l’attention de Googlebot. Le diagnostic par les logs serveur, souvent négligé au profit des seules données Search Console, reste l’outil le plus fiable pour objectiver ce type de gaspillage avant d’intervenir.