Une agence reprend la gestion technique d’un site e-commerce dont l’accès à la propriété Search Console d’origine a été perdu lors du changement de prestataire précédent. Une nouvelle propriété a été créée, mais elle repart avec un historique vide, incapable de fournir la moindre donnée sur le comportement de Googlebot avant cette date. Pour comprendre comment le site est réellement exploré, une seule source reste disponible et fiable : les journaux d’accès bruts du serveur.
Ce que les logs contiennent que Search Console ne donne pas
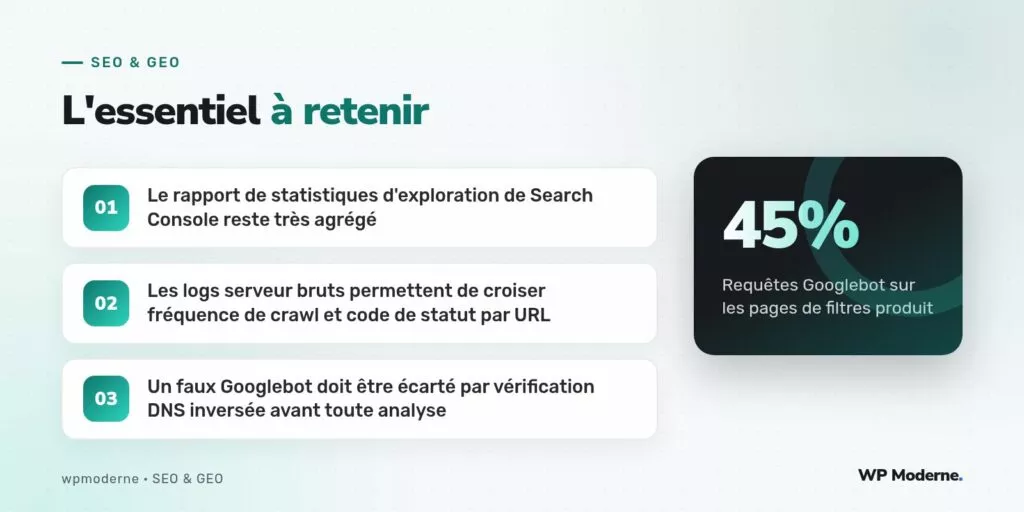
Le rapport de statistiques d’exploration de Search Console reste volontairement agrégé : il montre des tendances globales (nombre total de requêtes par jour, temps de réponse moyen, répartition par type de fichier) mais ne permet pas de descendre au niveau de l’URL individuelle avec autant de détail que les logs bruts. Ces derniers contiennent chaque requête effectuée par chaque robot, avec l’URL exacte, le code de statut retourné, l’horodatage précis et le user-agent déclaré, une granularité que Search Console ne fournit jamais.
Isoler les vraies requêtes de Googlebot
La première étape consiste à extraire uniquement les lignes correspondant à Googlebot, en se méfiant des faux positifs : n’importe quel script peut se déclarer avec un user-agent « Googlebot » sans être le véritable robot de Google. Une extraction initiale par simple correspondance de texte suffit pour un premier tri :
grep "Googlebot" /var/log/apache2/access.log > googlebot-brut.log
wc -l googlebot-brut.log
Pour confirmer qu’une adresse IP appartient réellement à Google, la méthode recommandée par Google elle-même consiste en une résolution DNS inversée suivie d’une résolution directe de vérification :
host 66.249.66.1
# doit renvoyer un nom se terminant par .googlebot.com ou .google.com
host crawl-66-249-66-1.googlebot.com
# doit renvoyer la même adresse IP de départ
Construire une vue exploitable à partir du brut
Une fois les lignes de Googlebot confirmées isolées, il devient possible de construire des agrégations utiles pour le diagnostic, par exemple le nombre de requêtes par répertoire du site sur la période analysée :
awk '{print $7}' googlebot-brut.log | awk -F'/' '{print $2}' | sort | uniq -c | sort -rn | head -20
Sur ce site e-commerce, cette agrégation a révélé que le répertoire correspondant aux pages de filtres produit concentrait à lui seul près de 45 % des requêtes de Googlebot sur le mois analysé, une proportion largement disproportionnée par rapport au nombre réel de fiches produit du catalogue, et un signal fort de gaspillage de budget de crawl sur ce type d’URL.
Croiser fréquence de crawl et codes de statut
L’étape suivante consiste à croiser cette fréquence d’exploration avec les codes de statut retournés, pour repérer les cas où Googlebot insiste sur des URL qui ne répondent pas correctement :
- Des codes 404 récurrents sur une même URL indiquent un lien interne cassé qui continue d’être suivi par Googlebot malgré l’absence de contenu.
- Des codes 301 en chaîne, visibles par plusieurs lignes consécutives pour la même requête logique, confirment un problème de redirection déjà identifié ailleurs.
- Des temps de réponse anormalement longs sur certaines URL de recherche ou de filtre peuvent expliquer une baisse générale du volume de pages explorées par jour, Google ajustant son rythme d’exploration à la vitesse de réponse perçue du serveur.
Ce que cet audit a permis de recommander au client
Sur la base de cette analyse, l’agence a pu recommander deux actions concrètes sans attendre l’accumulation de données dans la nouvelle propriété Search Console : bloquer l’exploration des combinaisons de filtres produit responsables de 45 % du volume, et corriger une série de liens internes cassés repérés directement dans les logs, avant même qu’ils ne remontent dans le rapport de couverture de la nouvelle propriété, plusieurs semaines plus tard.
Face à un client qui a perdu l’historique Search Console, ne pas attendre passivement que les nouvelles données s’accumulent : les logs serveur bruts racontent souvent la même histoire, avec plusieurs semaines d’avance.
Bilan de la méthode
L’analyse de logs serveur demande davantage de manipulation en ligne de commande que la lecture d’un tableau de bord Search Console, mais elle offre une granularité et une immédiateté que ce dernier ne propose pas. Pour une agence qui reprend un projet sans historique de données, ou qui veut simplement vérifier ce que Search Console résume trop grossièrement, cette méthode reste la référence pour objectiver le comportement réel de Googlebot sur un site.