Un client avait suivi scrupuleusement la mise en place d’un fichier llms.txt sur son site WordPress, avec une liste soignée de ses pages prioritaires. Six semaines plus tard, l’analyse des logs serveur ne montrait strictement aucune requête sur ce fichier, de la part d’aucun robot identifié. Le fichier existait, semblait correct à l’œil, et pourtant restait invisible pour ceux à qui il était destiné.
Ce cas illustre une réalité qu’il faut garder à l’esprit avec une convention aussi récente : l’absence de norme officielle strictement contraignante laisse place à des variations d’implémentation, et un diagnostic minutieux reste nécessaire avant de conclure à un défaut du site lui-même.
Vérification 1 : le chemin exact du fichier
Premier point de contrôle, le plus basique mais souvent négligé : le fichier était-il bien accessible à la racine exacte du domaine, à l’adresse https://exemple.fr/llms.txt, et non dans un sous-dossier ou derrière une redirection intermédiaire ? Une vérification avec curl a montré un problème immédiat :
curl -IL https://exemple.fr/llms.txt
# HTTP/1.1 301 Moved Permanently
# Location: https://www.exemple.fr/llms.txt
# HTTP/1.1 200 OK
Le fichier existait bien, mais uniquement accessible après une redirection de la version sans www vers la version avec www du domaine. Ce genre de redirection ne pose généralement aucun problème pour un crawl classique habitué à suivre les redirections HTTP, mais certains robots plus légers, conçus pour une collecte rapide de fichiers texte statiques, n’appliquent pas systématiquement ce comportement de suivi.
Vérification 2 : le type de contenu retourné
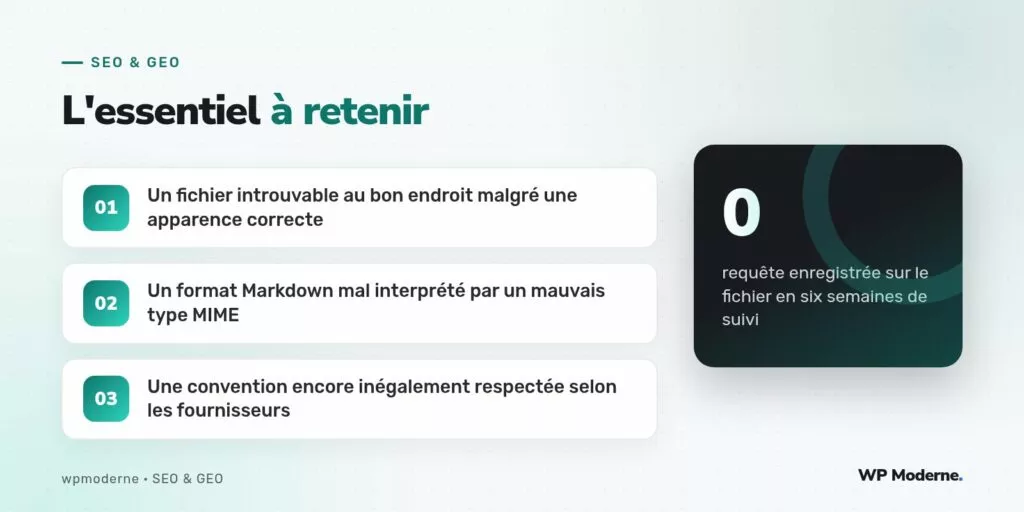
Deuxième point de contrôle : le fichier était-il servi avec l’en-tête Content-Type attendu ? La configuration du serveur, héritée d’une règle générique appliquée à tous les fichiers .txt, retournait un type application/octet-stream plutôt que text/plain, ce qui peut amener certains lecteurs automatisés stricts à traiter le fichier comme un binaire à télécharger plutôt qu’un texte à analyser directement.
# Configuration corrigee dans le serveur
<FilesMatch "llms\.txt$">
    Header set Content-Type "text/plain; charset=utf-8"
</FilesMatch>
Vérification 3 : le format Markdown lui-même
Une fois le chemin et le type de contenu corrigés, une relecture attentive du contenu a révélé un problème plus subtil : la convention llms.txt attend une structuration précise, avec un titre H1 en tout début de fichier et des sections en H2 clairement délimitées. Le fichier du client commençait par un paragraphe d’introduction non structuré, avant le moindre titre Markdown, ce qui peut désorienter un analyseur strict conçu pour attendre ce format dès la première ligne.
# Avant correction (introduction non structuree en tete de fichier)
Bienvenue sur le llms.txt de notre site, voici nos pages principales.

## Pages essentielles
...

# Apres correction (titre H1 en premiere ligne, conforme a la convention)
# Nom du site

> Description courte du site en une phrase.

## Pages essentielles
...
Ce qu’il restait à accepter : l’adoption inégale de la convention
Après ces trois corrections, le suivi des logs sur les semaines suivantes a montré une première requête identifiée, six jours après la correction, en provenance d’un robot associé à un fournisseur de moteur de réponse. Mais l’adoption reste très inégale d’un fournisseur à l’autre : certains robots majeurs n’avaient, à la date de rédaction, toujours donné aucun signe de consultation systématique du fichier, ce qui reste cohérent avec le caractère encore expérimental de cette convention.
Prévention pour un prochain projet
- Toujours tester l’accès au fichier sur la version canonique exacte du domaine, sans redirection intermédiaire.
- Vérifier explicitement l’en-tête
Content-Typeretourné, en particulier sur les serveurs avec des règles génériques par extension. - Respecter scrupuleusement la structure Markdown attendue, titre H1 en première ligne inclus, même si aucune norme officielle ne sanctionne formellement un écart.
Une convention non normée par un organisme officiel n’en est pas moins exigeante : sans spécification stricte à faire valoir, c’est la rigueur d’implémentation qui fait toute la différence entre un fichier lu et un fichier ignoré.
En résumé
Un fichier llms.txt ignoré par les robots n’est presque jamais un problème de contenu éditorial, mais un problème de chemin, de type de contenu ou de structure Markdown. Ce diagnostic en trois temps permet d’écarter méthodiquement chaque cause avant de conclure, à tort, que la convention elle-même serait sans effet sur le site concerné.