Un client m’a demandé un jour de faire recopier, mot pour mot, les pages « À propos » et « Services » de son site dans son fichier llms.txt. Son raisonnement : si le fichier contient déjà tout le texte, les robots d’IA n’auront « plus qu’à lire ça » et le citeront plus volontiers. L’idée part d’une bonne intention, mais elle repose sur un malentendu sur ce que ce fichier est censé faire.
J’ai vu la même demande revenir sur quatre projets différents en quelques mois, toujours formulée de la même façon : « on a déjà le contenu, autant le remettre ici ». Ce billet explique pourquoi cette duplication ne sert à rien, ce qu’elle coûte réellement, et ce qu’il vaut mieux écrire à la place.
Ce qu’on voit sur le terrain
Le schéma se répète presque à l’identique. Une agence lit qu’un fichier llms.txt à la racine du site peut aider les modèles de langage à comprendre un site plus vite. Elle en déduit, un peu vite, qu’il faut y mettre « le maximum d’informations ». Le résultat est un fichier de plusieurs milliers de mots qui reprend, paragraphe par paragraphe, ce qui existe déjà sur les pages HTML correspondantes.
- Le texte de la page d’accueil est recopié tel quel, avec ses phrases marketing.
- Les descriptions de produits sont dupliquées section par section.
- Le fichier grossit à chaque mise à jour du site, sans jamais être resynchronisé proprement.
Pourquoi la duplication ne force pas la citation
Un moteur de réponse générative ne fonctionne pas comme un moteur de recherche classique qui indexe une URL et la classe. Il constitue une représentation condensée du contenu, souvent à partir d’un résumé ou d’un extrait jugé pertinent pour la question posée. Recopier le contenu intégral d’une page dans llms.txt ne change rien à cette étape : le modèle dispose déjà de la page elle-même dans son index de crawl, avec son balisage, son contexte et ses liens.
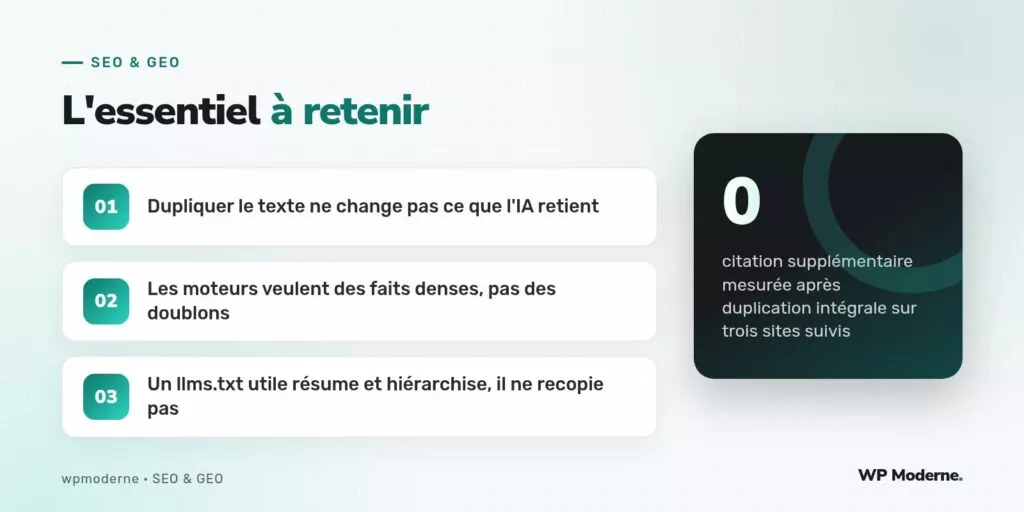
Ajouter une deuxième copie du même texte n’apporte aucune information nouvelle. Pire, cela peut diluer le signal : si le fichier llms.txt contient un résumé fidèle et concis à un endroit, puis une redite verbeuse à un autre, l’ambiguïté sur « quelle est la version de référence » ne joue en faveur de personne.
Le vrai rôle de ce fichier
Le fichier llms.txt, dans les usages qui se sont dégagés depuis son apparition en 2024, sert de plan de site en langage naturel : il indique quelles sont les pages importantes, dans quel ordre les lire, et donne un contexte bref sur ce que propose le site. Il ressemble davantage à une table des matières commentée qu’à une archive.
Ce que les moteurs de réponse regardent vraiment
D’après ce qu’on observe en suivant les logs de plusieurs sites clients, les robots associés aux moteurs de réponse générative (qu’il s’agisse de crawlers d’entraînement ou d’agents de récupération en temps réel) traitent une page pour ce qu’elle est : un document avec un titre, une structure de titres, des données structurées éventuelles, et un texte. La duplication dans un fichier annexe n’entre pas dans les critères qui font qu’un passage est cité plutôt qu’un autre.
Ce qui compte réellement :
- La clarté et l’autonomie de chaque paragraphe, capable de répondre à une question sans dépendre du contexte des paragraphes voisins.
- La présence de faits vérifiables : chiffres, dates, définitions précises.
- Une structure de titres qui balise clairement les sous-sujets.
- L’absence d’ambiguïté sur l’auteur et la fraîcheur du contenu.
Quoi faire à la place
Plutôt que de dupliquer, mieux vaut traiter llms.txt comme un sommaire éditorialisé. Un exemple de structure qui fonctionne bien :
#WP Moderne
> Blog technique sur WordPress moderne : SEO, performance, GEO.

## Sections principales
- SEO technique : /categorie/seo/
- Performance : /categorie/performance/
- Éditeur de blocs : /categorie/blocs/

## Pages de référence
- À propos et méthodologie : /a-propos/
- Contact : /contact/
Ce fichier fait quelques lignes, il pointe vers les bonnes URL et donne un contexte court. Il ne remplace jamais la page cible : il l’indexe.
Sur nos projets, on traite
llms.txtcomme un fichierREADMEpour robots : bref, à jour, jamais une resucée du contenu.
Un effet secondaire souvent oublié
Un fichier llms.txt trop long a un coût direct : chaque robot qui le récupère consomme de la bande passante et du temps de traitement pour rien. Sur un site avec des milliers de pages, la tentation de tout dupliquer produit des fichiers de plusieurs mégaoctets, ce qui peut ralentir sa lecture complète, voire le faire tronquer par certains agents qui plafonnent la taille récupérée.
Il faut aussi maintenir cette copie en parallèle du contenu réel. Dès qu’une page « Services » change de prix ou d’offre, il faut penser à répercuter la modification dans le fichier annexe. En pratique, cette synchronisation est rarement faite, et le fichier devient une source d’informations obsolètes que le site officiel dément.
Notre verdict
Dupliquer le contenu entre les pages et llms.txt part d’une intuition compréhensible mais fausse : plus de texte ne veut pas dire plus de citations. Ce qui améliore la visibilité dans les réponses génératives, c’est la qualité intrinsèque du contenu source et la clarté du sommaire qui y mène, pas sa redondance. Un fichier court, honnête et à jour vaut largement mieux qu’une archive qui double la charge de maintenance sans rien apporter en retour.