Sur un projet de fiche produit pour un client de vente de matériel de randonnée, l’équipe avait construit tout le comparatif de caractéristiques techniques en React, monté côté client au-dessus d’un squelette HTML quasiment vide. Dans Chrome, tout s’affichait sans accroc en une seconde. Ce qui a surpris l’équipe, c’est de constater qu’un robot d’IA testé en parallèle ne voyait rien de ce tableau : juste un conteneur vide et un message de chargement.
Ce genre d’écart entre ce qu’un humain voit dans son navigateur et ce qu’un agent automatisé récupère mérite d’être mesuré méthodiquement plutôt que supposé. Voici comment comparer les deux rendus sur un site WordPress qui embarque une part de JavaScript, et ce que ça change pour le GEO (l’optimisation pour les moteurs de réponse génératifs).
Deux façons de récupérer une même page
Un navigateur moderne télécharge le HTML, puis exécute le JavaScript, applique les styles, et affiche le résultat final : c’est le DOM après hydratation. Un robot, lui, peut choisir plusieurs stratégies selon son architecture : lire uniquement le HTML brut renvoyé par le serveur, exécuter une partie du JavaScript dans un environnement limité, ou ne rien exécuter du tout et se contenter du texte statique.
Sur le site testé, la comparaison donnait ceci :
| Élément de la page | Vu par un navigateur (Chrome) | Vu par le robot testé (HTML brut) |
|---|---|---|
| Titre et introduction | Présents | Présents |
| Tableau de caractéristiques | Présent, généré par React | Absent, conteneur vide |
| Avis clients | Chargés en différé (scroll) | Absents |
| Prix et disponibilité | Injectés via une requête API | Absents |
Pourquoi cet écart se produit sur un site WordPress
La plupart des thèmes WordPress classiques rendent le contenu côté serveur via PHP et la boucle WP_Query, ce qui produit un HTML complet dès la première réponse. L’écart apparaît surtout quand un bloc personnalisé, un plugin de comparateur ou une section entière de la page est confiée à un composant JavaScript qui va chercher ses données après le chargement initial, typiquement via fetch() vers une route de l’API REST de WordPress.
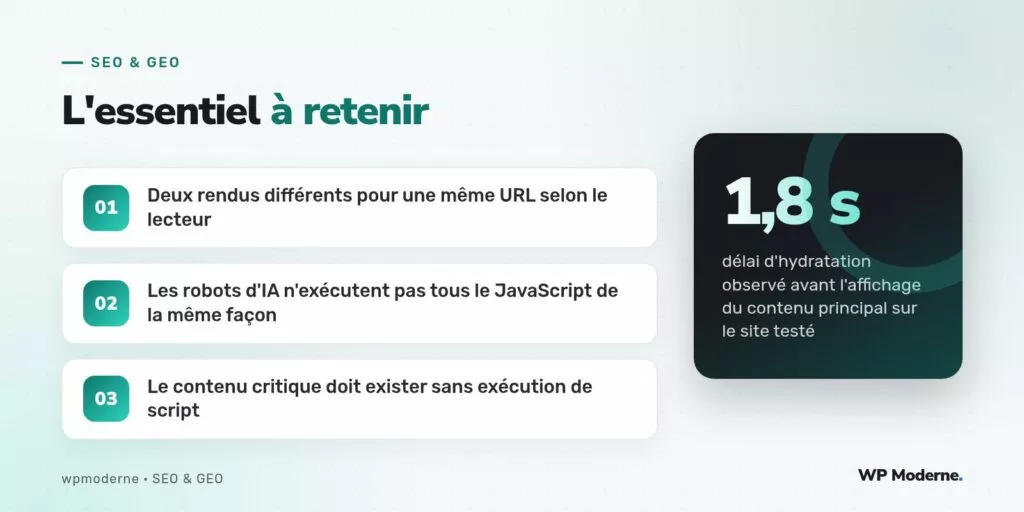
Ce n’est donc pas WordPress en tant que tel qui pose problème, mais la décision d’architecture de reporter une partie du contenu à l’exécution client. Un bloc Gutenberg qui affiche un système de notation en JavaScript pur, sans rendu côté serveur équivalent, produit exactement ce trou.
Comment vérifier l’écart sur son propre site
- Récupérer le HTML brut d’une page avec une requête simple :
curl -A "Mozilla/5.0" https://exemple.fr/produit/veste-goretex/ > brut.html. - Ouvrir
brut.htmldans un éditeur et chercher les blocs de contenu attendus (prix, description longue, avis). - Comparer avec le DOM affiché dans les outils de développement du navigateur, onglet Elements, après chargement complet.
- Noter chaque élément présent dans un cas et absent dans l’autre.
Cette méthode ne simule pas exactement le comportement de chaque robot d’IA, dont beaucoup restent opaques sur leur moteur de rendu, mais elle révèle un signal fiable : si le contenu n’existe pas dans le HTML brut, il est risqué de compter dessus pour être cité.
Ce que ça change concrètement pour la citation
Un moteur de réponse générative qui s’appuie sur un contenu tronqué ne peut citer que ce qu’il a effectivement lu. Si le tableau de caractéristiques n’existe pas dans le HTML brut, il ne fera jamais partie d’une réponse générée, même si le produit est objectivement complet et bien décrit visuellement pour un visiteur humain.
Une règle simple qu’on applique désormais : tout ce qui doit pouvoir être cité doit survivre à un
curlsans JavaScript.
- Rendre côté serveur les informations factuelles (prix, spécifications, disponibilité) via PHP, pas uniquement via une hydratation client.
- Réserver le JavaScript aux interactions non essentielles au sens du contenu (filtres, animations, favoris).
- Vérifier régulièrement le HTML brut des pages stratégiques, pas seulement leur rendu visuel.
En résumé
Le test le plus simple reste le plus révélateur : comparer un curl brut à ce que montre un navigateur. Sur ce projet de fiche produit, l’écart a justifié de réécrire le tableau de caractéristiques en rendu serveur via un short-code PHP appelant l’API du fournisseur au moment du build de la page, tout en gardant l’interactivité JavaScript pour le tri des colonnes. Le contenu qui compte pour la citation ne doit jamais dépendre d’une exécution que l’on ne contrôle pas.