Sur un mois de journaux d’accès, le user-agent de Googlebot apparaît plus de deux mille fois sur des URLs de filtres à facettes. Dans le rapport Pages de la Search Console, ces mêmes URLs figurent comme « Explorée actuellement non indexée », sans aucune mention du volume réel de passages. Deux sources censées décrire le même phénomène, deux récits sensiblement différents.
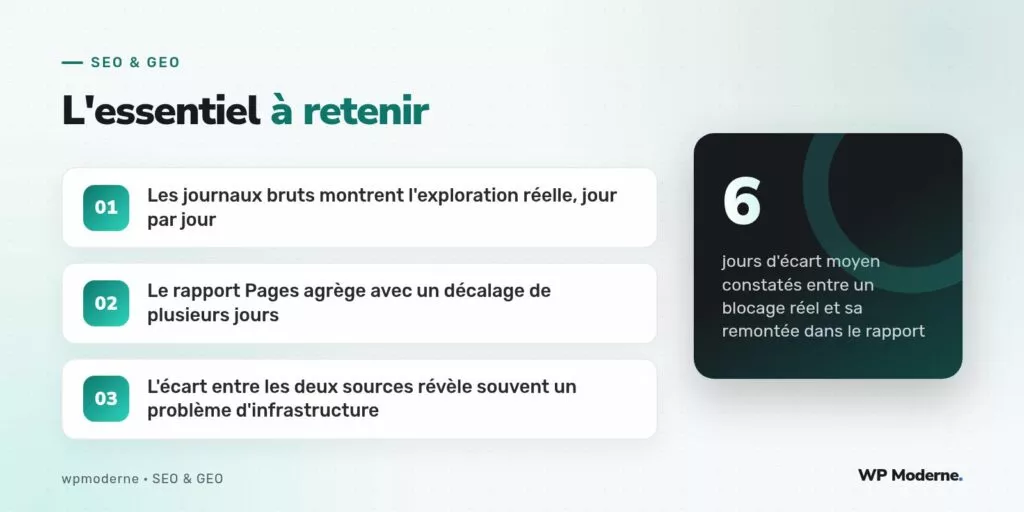
Cet écart n’est pas une anomalie de mesure : il vient de la nature même des deux outils. Les journaux serveur enregistrent chaque requête HTTP en temps réel, sans filtre ni agrégation. Le rapport Pages de la Search Console, lui, présente une vue consolidée, avec un délai de traitement et des catégories qui simplifient des situations parfois plus nuancées que ce qu’elles laissent paraître.
Ce que montrent les journaux bruts que Search Console ne montre pas
Un journal d’accès donne une granularité que l’interface ne propose jamais : l’heure exacte de chaque passage, le code de statut HTTP renvoyé, la taille de la réponse, et surtout la fréquence réelle sur une URL précise. Sur le site audité, ce niveau de détail a permis d’identifier que Googlebot revenait toutes les quatre heures sur un jeu d’URLs à paramètres de tri, en recevant systématiquement une réponse 200, sans jamais recevoir de code d’erreur qui aurait justifié l’abandon de ces pages.
- Fréquence de passage précise, minute par minute, sur chaque URL.
- Code de statut réel renvoyé, indépendamment de ce que rapporte l’interface.
- Volume total de bande passante consommé par le crawl sur une période donnée.
Le décalage temporel du rapport Pages
Le rapport Pages agrège les données avec un délai qui peut atteindre plusieurs jours entre l’exploration réelle et son affichage dans l’interface. Sur ce projet, un blocage introduit par erreur dans le fichier robots.txt a été corrigé en quarante-huit heures, mais l’interface a continué d’afficher les URLs concernées comme bloquées pendant près d’une semaine supplémentaire après la correction.
grep "Googlebot" access.log \
  | awk '{print $7}' \
  | sort | uniq -c | sort -rn \
  | head -n 20
Cette commande classe les URLs les plus explorées par Googlebot sur la période couverte par le journal, un classement qui ne dépend d’aucun délai de traitement et qui reflète l’activité réelle du robot au moment précis de l’extraction.
Un exemple concret : filtres à facettes ignorés côté rapport
Sur la boutique en ligne concernée, les journaux montraient un volume de crawl conséquent sur les combinaisons de filtres de couleur et de taille, alors que le rapport Pages regroupait la totalité de ces URLs sous une seule ligne « Dupliquée, Google a choisi une URL canonique différente de celle de l’utilisateur ». Cette agrégation masquait l’ampleur réelle du phénomène : sans les journaux, l’équipe aurait sous-estimé de moitié le volume de crawl consacré à des pages sans valeur de positionnement.
Comment recouper les deux sources méthodiquement
| Source | Ce qu’elle montre bien | Ce qu’elle montre mal |
|---|---|---|
| Journaux serveur bruts | Fréquence réelle, code de statut, volume | Aucune information sur l’indexation elle-même |
| Rapport Pages Search Console | Statut d’indexation par catégorie | Délai de traitement, agrégation qui masque le détail |
La méthode la plus fiable consiste à ne jamais se fier à une seule source. Un pic de crawl visible dans les journaux sur une famille d’URLs doit systématiquement être recoupé avec son statut dans le rapport Pages, en tenant compte du délai propre à ce dernier avant de conclure à une anomalie.
Un rapport d’indexation dit ce que Google a choisi de retenir. Un journal serveur dit ce que Googlebot a réellement fait. Les deux informations ne se substituent jamais l’une à l’autre.
En résumé
Quand les deux sources se contredisent, ce n’est ni un bug du rapport ni une erreur d’analyse des journaux : c’est le signe que le phénomène observé mérite d’être suivi dans la durée avant conclusion. Conserver un historique de journaux d’au moins un mois, et le confronter régulièrement au rapport Pages, reste la méthode la plus sûre pour distinguer un vrai problème d’un simple délai de traitement.