18 pages sur les 340 identifiées comme jamais explorées par Googlebot apparaissaient pourtant, à la surprise générale, comme sources citées dans des réponses générées par un moteur de réponse IA lors d’un audit de suivi de citations mensuel. La contradiction semblait évidente : comment un contenu invisible pour Google depuis cinq ans pouvait-il être connu, et cité avec un niveau de détail correct, par un système qui s’appuie pourtant largement sur des données issues du web indexé ?
L’audit de citations en question suit, chaque mois, un panel de requêtes liées à l’activité du site — une association à but non lucratif publiant des ressources documentaires — et relève les sources mentionnées dans les réponses obtenues auprès de plusieurs moteurs de réponse. La détection de ces 18 pages a déclenché une enquête approfondie plutôt qu’un simple constat, car la question sous-jacente touchait à la fiabilité même de l’attribution des moteurs de réponse.
Première étape : confirmer l’absence réelle dans l’index Google
Avant toute hypothèse, il fallait écarter une erreur de méthode. La commande site: sur Google, complétée par une recherche exacte sur des extraits de titre, n’a renvoyé aucun résultat pour les 18 URL concernées. Le rapport « Couverture » de Search Console, sur la propriété du domaine, classait ces pages en Découverte, actuellement non indexée pour certaines, et en Exclue par la balise noindex pour d’autres — deux statuts distincts qui allaient s’avérer être deux causes différentes du même effet global.
L’analyse des logs serveur bruts, filtrés sur les user-agents Googlebot vérifiés, a confirmé l’absence totale de requête sur ces 18 URL depuis leur mise en ligne en 2021. Ce n’était donc pas un problème de désindexation après passage, mais une absence de crawl depuis l’origine.
Deuxième étape : retrouver la source réelle de la citation
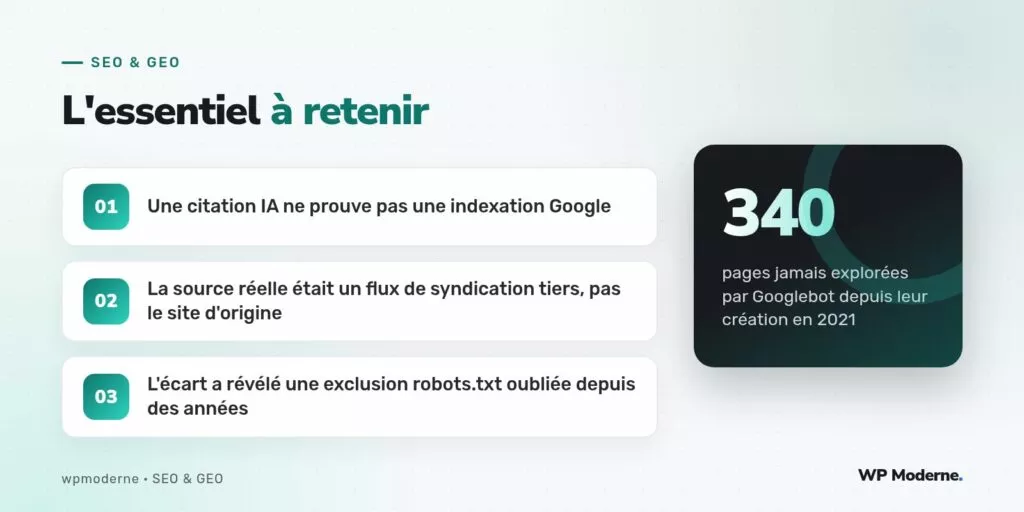
Le point tournant de l’enquête a consisté à examiner précisément le contenu cité par le moteur de réponse IA, plutôt que de se contenter de constater qu’il correspondait au sujet des pages du site. En comparant mot à mot un extrait cité avec le texte original des pages, une différence subtile est apparue : une reformulation légère, des paragraphes réordonnés, et une date de publication différente affichée par la source alléguée. Ce n’était pas le site d’origine qui avait été la source d’apprentissage ou de récupération du moteur de réponse, mais une republication de ce contenu sur un portail associatif partenaire, qui syndiquait automatiquement les ressources documentaires depuis 2021 via un flux XML fourni par l’association elle-même — un flux mis en place bien avant l’audit, et dont personne en interne ne s’était soucié du référencement propre.
Ce portail partenaire, correctement indexé par Google de son côté, publiait donc le même contenu sous sa propre URL, avec sa propre autorité de domaine, pendant que l’original restait invisible faute d’exploration. Le moteur de réponse IA avait fini par apprendre ou récupérer ce contenu via cette republication, sans jamais remonter jusqu’à la source première.
Troisième étape : comprendre pourquoi Googlebot n’était jamais passé
La cause de l’absence de crawl s’est révélée d’une simplicité presque déconcertante une fois localisée : le fichier robots.txt du site contenait depuis 2021 une règle héritée d’un environnement de préproduction jamais nettoyée lors de la mise en production initiale :
User-agent: *
Disallow: /ressources/
Toutes les pages de la section documentaire, y compris les 18 concernées, avaient été placées sous ce chemin lors de la création du site, sans que quiconque ne fasse le lien entre cette règle héritée et l’absence persistante de trafic organique sur cette section, mise sur le compte d’un simple manque de notoriété du contenu plutôt que d’un blocage technique explicite.
Ce que révèle cet écart sur la fiabilité des citations IA
Cette enquête a mis en évidence un point souvent sous-estimé : une citation par un moteur de réponse IA ne constitue en aucun cas une preuve d’indexation par Google, ni même une preuve que le moteur a directement consulté le site cité comme origine du contenu. La chaîne d’attribution peut passer par des intermédiaires — republications, syndications, agrégateurs — que l’utilisateur final de la réponse ne voit jamais, et que le site d’origine peut ignorer complètement s’il ne surveille pas activement ses propres citations.
Enseignements retenus pour la suite
- Un audit de citations IA doit systématiquement inclure une vérification de l’indexation Google du contenu cité, pas seulement une vérification de sa présence sur le site d’origine.
- Tout flux de syndication ou de republication mis en place avec un partenaire doit être documenté et revu périodiquement, pas seulement configuré une fois puis oublié.
- Un fichier
robots.txthérité d’un environnement de préproduction est un risque suffisamment fréquent pour justifier une vérification systématique lors de tout audit technique, même sur un site en place depuis des années.
Voir son propre contenu cité par une IA peut donner un faux sentiment de bonne santé SEO ; la première question à se poser est toujours « cité depuis où, exactement ».
En résumé
Ce cas illustre un écart rarement documenté entre visibilité dans les moteurs de réponse IA et indexation classique : un contenu totalement absent de l’index Google depuis cinq ans, à cause d’une règle robots.txt héritée jamais corrigée, a néanmoins fini par être cité grâce à sa republication sur un portail tiers correctement indexé. La correction technique du blocage a été traitée séparément de cette enquête ; ce qui mérite d’être retenu ici, c’est la méthode d’investigation elle-même, transposable à tout site qui découvrirait un écart similaire entre ce que Google connaît et ce qu’un moteur de réponse semble savoir.