« Structured Data helps search engines understand the content of your page. » La documentation de Google sur les données structurées ne parle que de moteurs de recherche classiques, pas de moteurs de réponse génératifs — et c’est précisément le trou dans la raquette que rencontre tout développeur qui doit prioriser son temps de balisage face à la centaine de types disponibles sur schema.org, sans savoir lesquels comptent réellement pour ChatGPT, Perplexity ou les AI Overviews de Google.
Sur un panel de douze sites WordPress suivis depuis 2025, avec un balisage JSON-LD différent testé site par site, un travail a consisté à croiser deux données : la présence ou l’absence de chaque type de balisage, et l’apparition ou non du site comme source citée dans des réponses générées par ces moteurs, sur un corpus de plusieurs centaines de requêtes suivies mensuellement. Les résultats ne couvrent évidemment pas tout le spectre Schema.org, mais ils dessinent une hiérarchie claire entre les types qui comptent et ceux qui n’ont montré aucun effet mesurable.
Les types dont l’effet a pu être observé
Article arrive en tête sans surprise : sa présence, avec des champs correctement renseignés (headline, datePublished, author, publisher), corrèle avec une meilleure identification de la source par les moteurs de réponse, probablement parce que ces champs recoupent des signaux déjà utilisés pour l’évaluation E-E-A-T côté Google et réutilisés par des modèles entraînés en partie sur des données indexées classiquement.
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Titre exact de l'article",
  "datePublished": "2026-06-01T09:00:00+02:00",
  "author": { "@type": "Person", "name": "Nom de l'auteur" },
  "publisher": { "@type": "Organization", "name": "Nom du site" }
}
Organization et Person, utilisés en cohérence sur l’ensemble d’un site plutôt que déclarés une seule fois de façon isolée, ont montré un effet sur la confiance perçue : plusieurs réponses générées citaient explicitement l’organisation ou l’auteur par son nom, ce qui suggère que ces entités sont bien résolues et associées au contenu source, même quand l’URL exacte n’est pas mentionnée dans la réponse.
FAQPage reste lu et exploité, mais différemment de son usage classique en rich results Google : plutôt que d’être cité tel quel, son contenu semble parfois repris et reformulé dans la réponse générée sans attribution explicite à la source — un comportement qui pose une vraie question d’équité de citation, mais qui confirme au moins que ce balisage est traité comme une source de paires question-réponse fiables.
Les types sans effet observable
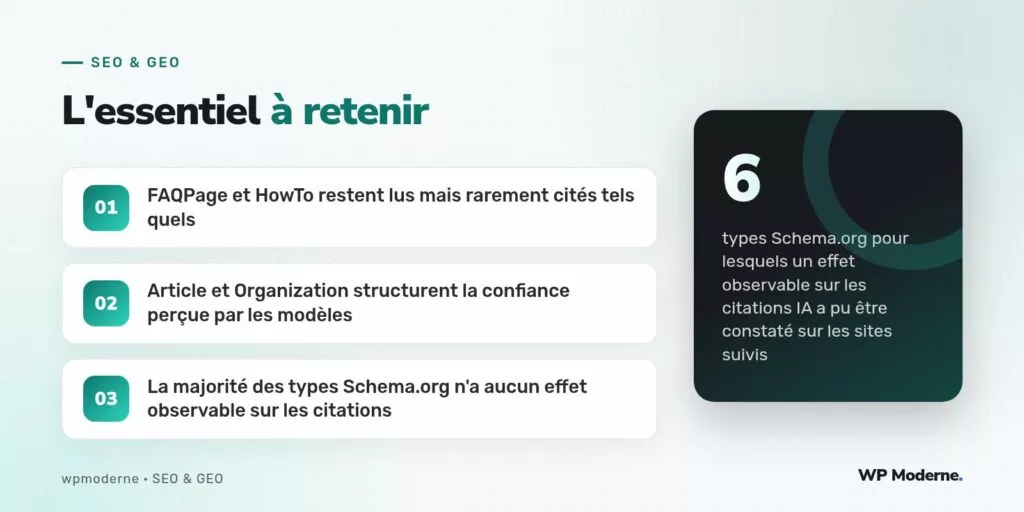
À l’inverse, des types pourtant recommandés pour le rich results classique n’ont montré aucune corrélation mesurable avec une meilleure citation par les moteurs de réponse sur le panel suivi : BreadcrumbList, VideoObject hors plateformes vidéo dédiées, ou encore Event pour du contenu à durée de vie courte. Ce n’est pas une preuve définitive d’inutilité — l’échantillon reste limité — mais cela invite à ne pas transposer telle quelle la logique de priorisation du SEO classique vers le GEO : un type très utile pour un rich result Google peut être ignoré par un modèle de langage qui ne traite pas la page de la même façon qu’un moteur d’indexation traditionnel.
Une hypothèse sur le mécanisme en jeu
Le point commun des types qui « comptent » semble être leur capacité à fournir une structure sémantique directement réutilisable dans une réponse en langage naturel : une question suivie d’une réponse (FAQPage), une affirmation d’autorité (Article avec auteur et éditeur identifiés), une entité nommée cohérente à travers le site (Organization, Person). À l’inverse, les types qui décrivent une structure de navigation ou un format multimédia (BreadcrumbList, VideoObject) apportent une information utile pour un moteur de recherche classique, mais peu exploitable telle quelle dans une réponse textuelle générée.
Cette hypothèse reste à confirmer sur un panel plus large, mais elle a une conséquence pratique immédiate : plutôt que de viser l’exhaustivité du balisage Schema.org, il est plus rentable de soigner en priorité un socle réduit de types bien renseignés et cohérents sur l’ensemble du site, que de multiplier les types secondaires en espérant un effet cumulatif qui n’a, à ce jour, pas été observé.
Priorisation recommandée pour un site de contenu
- Article ou BlogPosting, avec auteur, date et éditeur systématiquement renseignés sur chaque contenu.
- Organization, déclaré une seule fois de façon cohérente, avec logo, nom et description stables dans le temps.
- Person pour chaque auteur récurrent, relié à l’Organization par la propriété
worksForquand c’est pertinent. - FAQPage uniquement sur les contenus qui contiennent réellement des questions-réponses explicites, pas en balisage forcé.
Mieux vaut quatre types de balisage bien tenus et cohérents dans le temps qu’une douzaine de types ajoutés une fois puis jamais maintenus.
Notre verdict
Sur les moteurs de réponse suivis, six types Schema.org ont montré un effet observable sur les citations : Article, Organization, Person, FAQPage en tête, avec des nuances selon la façon dont le contenu est repris. La grande majorité du vocabulaire Schema.org, bien qu’utile pour le SEO classique, n’a pas démontré d’effet mesurable dans ce contexte précis. Cela ne justifie pas d’abandonner un balisage exhaustif là où il sert déjà le rich results Google, mais cela doit guider la priorité de temps de développement quand l’objectif spécifique est la citation par un moteur de réponse IA plutôt que le classement classique.