Sur quel site faut-il intervenir aujourd’hui, parmi cent cinquante sites clients suivis par une même agence ? La question, posée chaque matin par l’équipe de support technique, ne trouvait pas de réponse satisfaisante dans les interfaces natives de Sentry ou de Cloudflare Analytics, chacune limitée à une vue par projet ou par zone, sans agrégation transversale ni priorisation automatique.
Un tableau de bord maison a été construit pour répondre précisément à cette question, en agrégeant les métriques de performance applicative de Sentry et les métriques réseau de Cloudflare Analytics dans une seule vue, avec un score de priorité calculé automatiquement pour chaque site du parc.
Les deux sources de données à réconcilier
Sentry Performance fournit, par site, des métriques applicatives : temps de réponse p95 par transaction, taux d’erreurs, et désormais des données de profiling continu sur certains projets. Cloudflare Analytics, de son côté, fournit des métriques réseau : requêtes par seconde, taux de cache-hit, part du trafic bloqué par le WAF, latence à l’edge. Ces deux jeux de données ne partagent aucune clé commune nativement, chacun organisé selon la logique propre à son outil.
Le pont entre les deux a été établi via un identifiant de site normalisé, maintenu dans une table de correspondance, associant le nom de projet Sentry et la zone Cloudflare correspondante pour chacun des cent cinquante sites du parc.
Le score de priorité
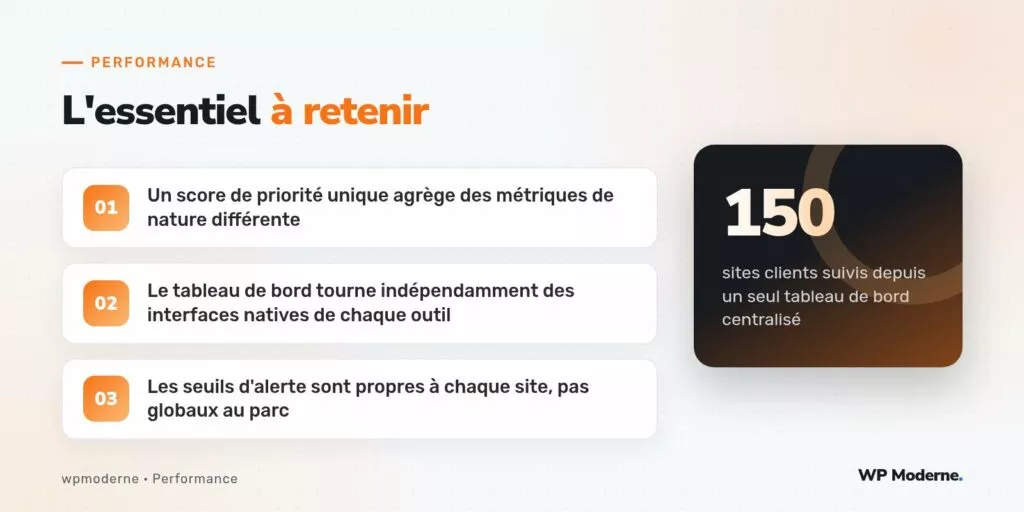
Plutôt que d’afficher des métriques brutes site par site, ce qui aurait simplement déplacé le problème de priorisation vers l’humain, un score composite a été défini, pondérant trois facteurs : la dégradation relative du temps de réponse p95 par rapport à la moyenne historique du site sur trente jours, le taux d’erreurs applicatives, et la chute du taux de cache-hit Cloudflare, chacun rapporté à la baseline propre de chaque site plutôt qu’à un seuil global au parc.
score_priorite = (
    0.4 * ecart_relatif_p95 +
    0.4 * taux_erreurs_normalise +
    0.2 * chute_cache_hit_relative
)
// Chaque composante est calculee par rapport a la baseline
// des 30 derniers jours du site concerne, pas a un seuil fixe
Ce choix de baseline propre à chaque site s’est imposé après un premier essai avec des seuils fixes identiques pour tout le parc, qui noyait systématiquement les petits sites à faible trafic sous les alertes des gros sites e-commerce, dont les variations normales dépassaient largement les seuils calibrés pour les plus petits.
Architecture de collecte
- Une tâche planifiée interroge l’API Sentry toutes les quinze minutes pour chaque projet du parc, et stocke les métriques agrégées dans une base de données dédiée au tableau de bord.
- Une seconde tâche interroge l’API GraphQL de Cloudflare Analytics selon le même rythme, pour les mêmes zones associées.
- Un calcul de score s’exécute après chaque cycle de collecte, et alimente une file d’alertes consultée par l’équipe de support en début de journée.
Ce que le tableau de bord a changé dans les priorités
| Avant le tableau de bord | Après le tableau de bord |
|---|---|
| Interventions déclenchées par des signalements clients | Interventions anticipées sur détection de dégradation |
| Attention concentrée sur les plus gros clients par habitude | Priorité recalculée objectivement chaque matin |
| Deux outils consultés séparément, sans vue croisée | Une seule vue combinant applicatif et réseau |
Un tableau de bord d’agence ne doit jamais reproduire ce que l’outil source affiche déjà : il doit répondre à la question que l’équipe se pose vraiment, ici « où intervenir en premier », pas « que s’est-il passé sur ce site précis ».
Limites assumées de cette architecture
Le tableau de bord ne remplace jamais l’interface native de Sentry ou de Cloudflare pour un diagnostic approfondi : il sert exclusivement de couche de priorisation. Une fois un site identifié comme prioritaire, l’équipe bascule systématiquement vers les outils natifs pour l’investigation détaillée, le tableau de bord maison n’ayant pas vocation à dupliquer cette profondeur d’analyse.
Ce que ça change au quotidien
Sur un parc de cent cinquante sites, le temps passé chaque matin à identifier où intervenir est passé d’environ quarante-cinq minutes de consultation croisée entre plusieurs interfaces à moins de cinq minutes de lecture d’une liste déjà priorisée. Le gain ne vient pas d’une nouvelle donnée collectée, mais de l’agrégation et de la priorisation de données déjà disponibles séparément.