1 240 requêtes SQL pour afficher une seule page de suivi de dossier : c’est le chiffre qu’a renvoyé le premier profilage de l’intranet d’une collectivité territoriale, un back-office utilisé quotidiennement par une centaine d’agents pour instruire des demandes administratives. Le ressenti des utilisateurs — « ça rame le lundi matin » — ne suffisait pas à savoir où intervenir en premier.
Sentry Performance, déjà installé pour le suivi des erreurs applicatives, a été activé en mode traces distribuées sur les parcours les plus consultés. Contrairement à un profilage ponctuel avec Query Monitor, les traces Sentry ont accumulé plusieurs semaines de données réelles, avec la répartition du temps entre PHP, base de données et appels externes, sur des centaines de sessions d’agents différents plutôt que sur une poignée de tests manuels.
Ce que les traces ont montré en premier
Le tableau de transactions de Sentry a classé les routes par temps de réponse moyen pondéré par le nombre d’appels, un angle très différent d’un audit classique qui se concentre souvent sur la page d’accueil. La page de suivi de dossier, consultée des centaines de fois par jour, dominait largement le classement malgré un temps de réponse individuel qui semblait acceptable pris isolément.
En ouvrant le détail d’une transaction lente, la répartition affichée par Sentry a immédiatement pointé trois zones distinctes : une boucle de champs personnalisés Advanced Custom Fields exécutée sans mise en cache, une requête de comptage sur une table de statuts sans index adapté, et un appel sortant vers un service de vérification d’identité déclenché à chaque affichage, y compris quand rien n’avait changé depuis la dernière visite.
Premier correctif : la boucle ACF
Le gabarit de la page de suivi appelait get_field() une vingtaine de fois par ligne de statut affichée, sans jamais s’appuyer sur get_fields() pour charger l’ensemble des champs en une seule opération. Sur un dossier comportant en moyenne quinze étapes de suivi, cela représentait à lui seul plusieurs centaines de requêtes redondantes par affichage.
// Avant : un appel get_field() par champ, dans la boucle
foreach ( $etapes as $etape ) {
    $statut = get_field( 'statut', $etape->ID );
    $date   = get_field( 'date_statut', $etape->ID );
    $agent  = get_field( 'agent_responsable', $etape->ID );
}

// Après : un seul appel groupé par étape
foreach ( $etapes as $etape ) {
    $champs = get_fields( $etape->ID );
    $statut = $champs['statut'];
    $date   = $champs['date_statut'];
    $agent  = $champs['agent_responsable'];
}
Deuxième correctif : l’index manquant
La requête de comptage sur la table de statuts effectuait un COUNT(*) filtré sur une colonne meta non indexée, un schéma classique avec des métadonnées personnalisées WordPress. Un index composite ajouté via une migration dédiée a fait chuter le temps de cette requête de 380 ms à 12 ms en moyenne, un gain visible immédiatement dans les traces suivantes de Sentry.
Troisième correctif : l’appel externe superflu
L’appel de vérification d’identité, hébergé chez un prestataire externe, était rejoué à chaque chargement de page alors que le statut vérifié ne changeait qu’une fois par dossier. Un transient WordPress de 24 heures a suffi à éliminer cet appel réseau bloquant sur la quasi-totalité des affichages :
- Vérification mise en cache via
get_transient()/set_transient()avec une durée de 24 heures. - Invalidation explicite du transient au moment où le statut du dossier change réellement.
- Suppression de l’appel réseau bloquant sur environ 92 % des affichages de la page.
Résultat mesuré et suivi dans la durée
| Indicateur | Avant | Après |
|---|---|---|
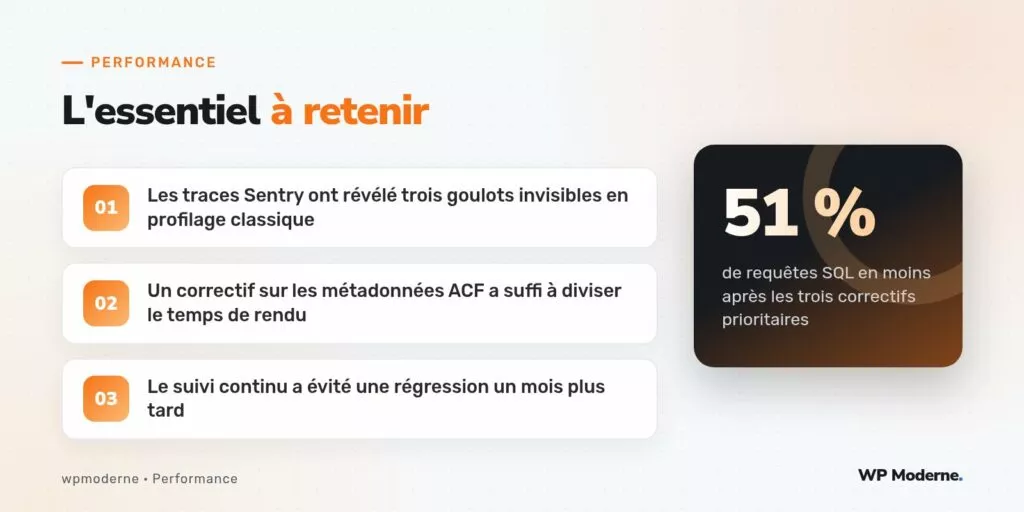
| Requêtes SQL par affichage | 1 240 | 610 |
| Temps de rendu moyen (p95 Sentry) | 2,9 s | 1,1 s |
| Appels externes par affichage | 1 systématique | quasi nul (caché) |
Un mois plus tard, une alerte Sentry a signalé une remontée progressive du temps de réponse sur la même page, provoquée par une mise à jour du plugin ACF qui modifiait légèrement le comportement de get_fields() dans un cas de champs répétables imbriqués. Sans le suivi continu, la régression serait passée inaperçue jusqu’aux premières remontées d’agents.
Un audit ponctuel dit ce qui est lent aujourd’hui. Un suivi continu dit quand ça recommence à l’être, souvent avant que les utilisateurs ne s’en plaignent.
Bilan chiffré
Sur cet intranet, les traces Sentry n’ont rien révélé d’exotique : une boucle de champs personnalisés, un index manquant, un appel externe non mis en cache. Ce sont les trois causes les plus banales de lenteur sur un back-office WordPress chargé en métadonnées, mais elles restent invisibles tant qu’on ne dispose pas d’une vue agrégée sur des semaines d’usage réel plutôt que sur quelques tests manuels.