« make.wordpress.org » décrit Action Scheduler comme la file d’attente de tâches de référence pour tout traitement différé sur WordPress, mais reste silencieux sur un angle mort bien réel : que se passe-t-il quand une tâche planifiée échoue, ou pire, ne se déclenche simplement plus jamais, sans qu’aucune erreur ne remonte nulle part ? Sur un site qui synchronise chaque nuit son catalogue de contacts avec HubSpot via une tâche récurrente, c’est exactement ce silence qui a motivé la mise en place du Cron Monitoring de Sentry.
Ce tutoriel détaille, étape par étape, l’instrumentation d’une tâche Action Scheduler existante avec ce mécanisme de surveillance, sans revenir sur la remontée d’erreurs applicatives classiques déjà couverte par ailleurs par le SDK Sentry standard.
Étape 1 : créer le moniteur côté Sentry
Un moniteur Cron se déclare dans l’interface Sentry (section « Crons »), avec un identifiant unique, une expression de planification au format cron, et une fenêtre de tolérance avant qu’un job soit considéré comme manqué. Pour une synchronisation nocturne prévue à 2h du matin :
Identifiant : synchro-hubspot-nocturne
Planification : 0 2 * * *
Tolérance de retard : 30 minutes
Durée maximale attendue : 45 minutes
Étape 2 : encadrer le début du job
Le SDK PHP de Sentry expose une méthode dédiée pour signaler le début d’exécution d’un job surveillé, à appeler juste avant que la logique métier ne démarre :
add_action( 'synchroniser_contacts_hubspot', function () {
    $check_in_id = \Sentry\captureCheckIn(
        'synchro-hubspot-nocturne',
        \Sentry\CheckInStatus::inProgress()
    );

    // Logique de synchronisation à suivre à l'étape 3
});
L’identifiant $check_in_id retourné par cet appel doit être conservé, car il permettra de rattacher les appels suivants (succès ou échec) au même « check-in » plutôt que d’en créer un nouveau sans lien avec le précédent.
Étape 3 : signaler le résultat, succès ou échec
add_action( 'synchroniser_contacts_hubspot', function () {
    $check_in_id = \Sentry\captureCheckIn(
        'synchro-hubspot-nocturne',
        \Sentry\CheckInStatus::inProgress()
    );

    try {
        $resultat = executer_synchronisation_hubspot();

        \Sentry\captureCheckIn(
            'synchro-hubspot-nocturne',
            \Sentry\CheckInStatus::ok(),
            null,
            $check_in_id
        );
    } catch ( \Throwable $e ) {
        \Sentry\captureCheckIn(
            'synchro-hubspot-nocturne',
            \Sentry\CheckInStatus::error(),
            null,
            $check_in_id
        );
        \Sentry\captureException( $e );
    }
});
Le bloc try/catch garantit qu’un échec de synchronisation, même provoqué par une exception non prévue dans le code de executer_synchronisation_hubspot(), se traduit toujours par un signal error() envoyé à Sentry plutôt que par une disparition silencieuse du check-in.
Étape 4 : vérifier le comportement en cas de non-exécution
Le scénario le plus insidieux n’est pas l’échec du job, déjà couvert par l’étape précédente, mais son absence totale d’exécution — un déclencheur WP-Cron qui ne se déclenche jamais faute de trafic sur un site à faible audience nocturne, par exemple. Ce cas a été testé en désactivant volontairement l’action pendant une nuit sur l’environnement de recette : Sentry a bien signalé le moniteur en statut « manqué » une fois la fenêtre de tolérance de 30 minutes dépassée, sans qu’aucun appel de check-in n’ait eu besoin d’être émis pour cela — c’est précisément l’intérêt de surveiller l’absence d’un signal plutôt que de se reposer uniquement sur la présence d’une erreur.
Étape 5 : brancher l’alerte sur le bon canal
- Une règle d’alerte Sentry a été configurée pour notifier l’équipe technique dès qu’un check-in du moniteur
synchro-hubspot-nocturnepasse en statut manqué ou en erreur. - Le canal de notification retenu a été un espace de discussion d’équipe dédié aux alertes d’infrastructure, distinct du canal des retours utilisateurs.
- Un test de bout en bout, en simulant une exception délibérée dans le code de synchronisation, a confirmé la réception de l’alerte dans un délai de quelques minutes.
Ce que cette instrumentation a changé concrètement
Avant sa mise en place, une panne de la synchronisation nocturne HubSpot ne se découvrait qu’indirectement, plusieurs jours plus tard, quand une personne de l’équipe commerciale remarquait des données de contact manifestement obsolètes. Après l’instrumentation, une interruption du job — qu’elle soit due à une erreur applicative, une indisponibilité de l’API HubSpot, ou un simple oubli de réactivation après une maintenance — déclenche une alerte dans la demi-heure suivant l’horaire prévu du job.
Un job planifié sans surveillance de son exécution effective n’est jamais vraiment fiable, même s’il fonctionne parfaitement depuis des mois.
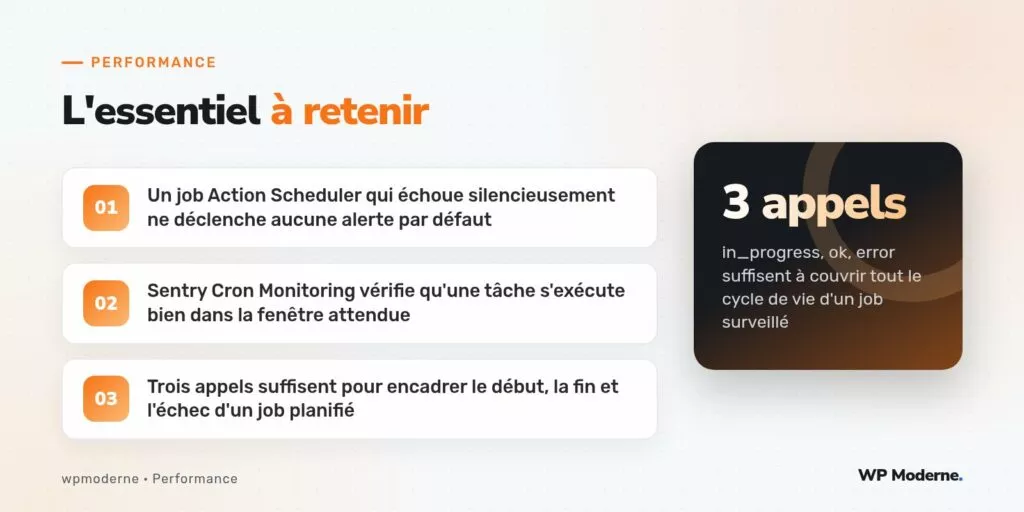
En résumé
Trois appels au SDK Sentry — début, succès, échec — suffisent à encadrer entièrement le cycle de vie d’une tâche Action Scheduler, à condition d’y ajouter la configuration du moniteur côté Sentry avec une planification et une tolérance de retard cohérentes avec le job réel. Cette instrumentation ne remonte aucune erreur applicative nouvelle par elle-même : elle rend simplement visible ce qui, jusque-là, ne l’était pas du tout.