Le symptôme est apparu progressivement sur un site de vente en gros de matériel professionnel : une tâche planifiée nocturne d’export des commandes vers un logiciel de comptabilité externe, censée durer une vingtaine de minutes, s’étirait chaque nuit un peu plus, jusqu’à atteindre six heures d’exécution et, certaines nuits, finir tuée par une limite de mémoire du serveur avant même d’avoir terminé son travail. L’export échouait alors silencieusement, laissant le service comptable découvrir le lendemain matin que les commandes de la veille manquaient à l’appel.
Symptôme : une dégradation progressive, pas un plantage immédiat
Ce qui distingue une fuite mémoire d’un simple dépassement de limite ponctuel, c’est la trajectoire dans le temps : la tâche fonctionnait parfaitement il y a six mois, avec une durée stable autour de vingt minutes, puis s’est mise à ralentir de façon régulière au fil des semaines, à mesure que le volume de commandes traitées augmentait. Ce profil de dégradation progressive, corrélé à la croissance du volume de données traité et non à un changement de code récent, pointait vers une fuite mémoire plutôt que vers une régression classique.
Diagnostic : profiler l’exécution complète du cron
Profiler une tâche cron pose une difficulté que profiler une requête web n’a pas : il faut capturer l’évolution de la mémoire sur toute la durée d’exécution, pas seulement un instantané. Blackfire a été utilisé ici en mode CLI, avec l’option de suivi de la mémoire activée sur toute la durée du script, exécuté manuellement sur un jeu de données réduit pour accélérer le cycle de diagnostic.
$ blackfire run --samples=1 wp cron event run export_commandes_compta --path=/var/www/grossiste
Le graphe de mémoire produit par Blackfire montrait une courbe qui ne redescendait jamais entre chaque commande traitée : la mémoire allouée augmentait de façon quasiment linéaire tout au long de l’exécution, signe classique d’objets qui ne sont jamais libérés par le ramasse-miettes de PHP.
La cause : un tableau de résultats accumulé sans jamais être vidé
La lecture du code de l’export a révélé la cause exacte : la fonction chargeait l’intégralité des commandes à exporter en mémoire dans un unique tableau PHP, avant de les traiter une par une, tout en conservant chaque commande déjà traitée dans ce même tableau pour un usage de journalisation en fin de script.
function exporter_commandes_compta() {
    $commandes = wc_get_orders( [ 'status' => 'completed', 'date_created' => '>' . strtotime( '-1 day' ), 'limit' => -1 ] );
    $log = [];

    foreach ( $commandes as $commande ) {
        $donnees = construire_donnees_export( $commande );
        envoyer_vers_compta( $donnees );
        $log[] = $donnees; // jamais vidé, jamais utilisé avant la toute fin
    }

    ecrire_journal_export( $log );
}
Avec plusieurs milliers de commandes par nuit, et chaque entrée du tableau $log contenant des objets de commande complets plutôt que de simples identifiants, la mémoire consommée par ce tableau croissait de façon linéaire avec le volume de commandes, jusqu’à représenter, en fin de script, plusieurs centaines de mégaoctets pour la seule journalisation d’un export qui n’en avait pas fondamentalement besoin.
Le correctif : traiter par lots et journaliser au fil de l’eau
La réécriture a supprimé l’accumulation en mémoire de toutes les commandes, en écrivant le journal ligne par ligne directement dans un fichier au fur et à mesure du traitement, et en libérant explicitement la mémoire des objets de commande dès qu’ils ne sont plus utiles avec wp_cache_flush_group() ciblé et un appel à unset().
function exporter_commandes_compta() {
    $fichier_journal = fopen( WP_CONTENT_DIR . '/logs/export-compta.log', 'a' );
    $commandes = wc_get_orders( [ 'status' => 'completed', 'date_created' => '>' . strtotime( '-1 day' ), 'limit' => -1, 'return' => 'ids' ] );

    foreach ( array_chunk( $commandes, 200 ) as $lot ) {
        foreach ( $lot as $id_commande ) {
            $commande = wc_get_order( $id_commande );
            $donnees = construire_donnees_export( $commande );
            envoyer_vers_compta( $donnees );
            fwrite( $fichier_journal, wp_json_encode( $donnees ) . "\n" );
            unset( $commande, $donnees );
        }
        wp_cache_flush_group( 'posts' );
    }

    fclose( $fichier_journal );
}
Deux changements ont eu l’effet le plus mesurable : récupérer d’abord uniquement les identifiants ('return' => 'ids') plutôt que des objets complets pour la liste initiale, et vider le groupe de cache d’objet posts à chaque lot de 200 commandes traitées, ce qui empêche l’accumulation d’objets mis en cache par WordPress lui-même pendant l’exécution du script.
Résultat mesuré
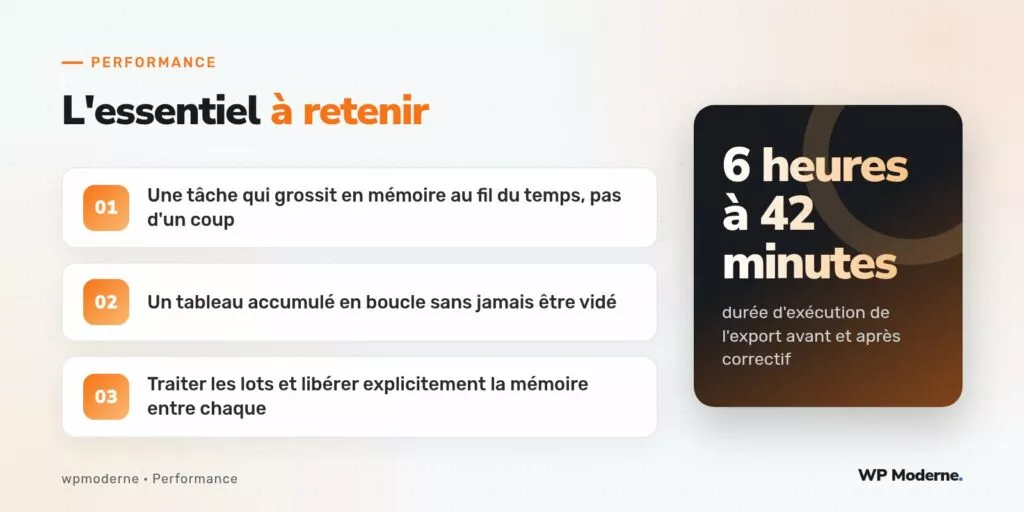
Après correctif, la même tâche traite un volume de commandes équivalent en 42 minutes, avec une consommation mémoire stable autour de 90 Mo tout au long de l’exécution au lieu d’une croissance continue qui finissait par dépasser 1,5 Go avant l’intervention.
- Une fuite mémoire se repère à sa trajectoire dans le temps, pas à un seul plantage isolé.
- Profiler l’exécution complète d’un cron, pas seulement un instantané, révèle les fuites progressives.
- Traiter par lots et libérer explicitement la mémoire évite l’accumulation silencieuse.
Un tableau qu’on remplit « pour la journalisation, juste au cas où » finit presque toujours par devenir le principal poste de consommation mémoire du script.
Pour aller plus loin
Cet article ne traite pas Action Scheduler ni le fonctionnement général de wp-cron, dont dépend le déclenchement de la tâche mais qui n’était pas en cause dans cet incident : une fois lancée, la tâche s’exécutait bien, elle grossissait simplement trop pour aller au bout dans un temps et une mémoire raisonnables.