GET /catalogue/produit-2847/ HTTP/1.1 — répété quatre mille fois par heure, depuis des dizaines de plages d’adresses IP différentes, sans jamais charger une seule image ni exécuter le moindre JavaScript. C’est la signature qu’ont fini par reconnaître les équipes d’une boutique en ligne, après avoir constaté que la charge serveur grimpait régulièrement sans que le nombre de commandes ou de visiteurs humains n’augmente en parallèle.
L’analyse des journaux d’accès a fini par isoler la cause : plusieurs robots d’entraînement de modèles d’intelligence artificielle moissonnaient l’intégralité du catalogue produit, page après page, à un rythme bien supérieur à celui d’un moteur de recherche classique. Or bloquer tous les robots à l’aveugle revenait à risquer de couper Googlebot ou Bingbot, avec un impact direct sur la visibilité du site. Il fallait distinguer, pas interdire en bloc.
Comment reconnaître un robot d’entraînement IA
Contrairement aux moteurs de recherche, qui respectent globalement le fichier robots.txt et déclarent un user-agent stable et documenté, une partie des robots d’entraînement IA se signale par un user-agent explicite (GPTBot, CCBot, ClaudeBot, Google-Extended pour l’entraînement spécifiquement, à distinguer de Googlebot classique), tandis qu’une autre partie tente de se fondre dans le trafic en usurpant des user-agents de navigateurs courants.
Le signal le plus fiable observé sur ce site n’était pas uniquement le user-agent déclaré, mais le comportement : un rythme de requêtes constant, sans variation jour/nuit, sur des pages profondes du catalogue jamais mises en avant, et une absence quasi totale de chargement des ressources statiques associées (images, CSS, JS), signe qu’aucun rendu de page n’était réellement effectué.
La recette Cloudflare mise en place
Cloudflare propose une catégorie dédiée dans son WAF pour les robots d’IA connus, activable sans écrire une seule règle personnalisée : le réglage « Bloquer les robots IA » sous Security > Bots, qui s’appuie sur la base de signatures maintenue par Cloudflare et distincte de la liste des robots de recherche légitimes.
{
  "rules": [
    {
      "description": "Bloquer les robots d'entrainement IA connus",
      "expression": "(cf.client.bot) and (cf.verified_bot_category eq \"AI Crawler\")",
      "action": "block"
    },
    {
      "description": "Challenge sur comportement suspect non identifie",
      "expression": "(http.request.uri.path contains \"/catalogue/\") and (rate(1m) > 120)",
      "action": "managed_challenge"
    }
  ]
}
La première règle s’appuie sur la catégorisation native de Cloudflare, qui distingue explicitement les robots d’entraînement IA vérifiés des robots de recherche légitimes (Googlebot, Bingbot restent dans une catégorie séparée et ne sont jamais concernés par cette règle). La seconde règle vise les comportements non identifiés qui dépassent un rythme de requêtes anormal sur les pages de catalogue, avec un défi géré plutôt qu’un blocage sec, pour laisser passer un humain qui naviguerait très vite.
Ce qu’il ne fallait surtout pas faire
- Bloquer par plage d’adresses IP : les robots d’entraînement IA changent régulièrement de fournisseur cloud, rendant ce filtrage rapidement obsolète.
- Bloquer tous les user-agents contenant « bot » : cela aurait exclu des outils de supervision légitimes utilisés en interne.
- Se fier uniquement au fichier
robots.txt: une partie des robots d’entraînement IA l’ignore purement et simplement.
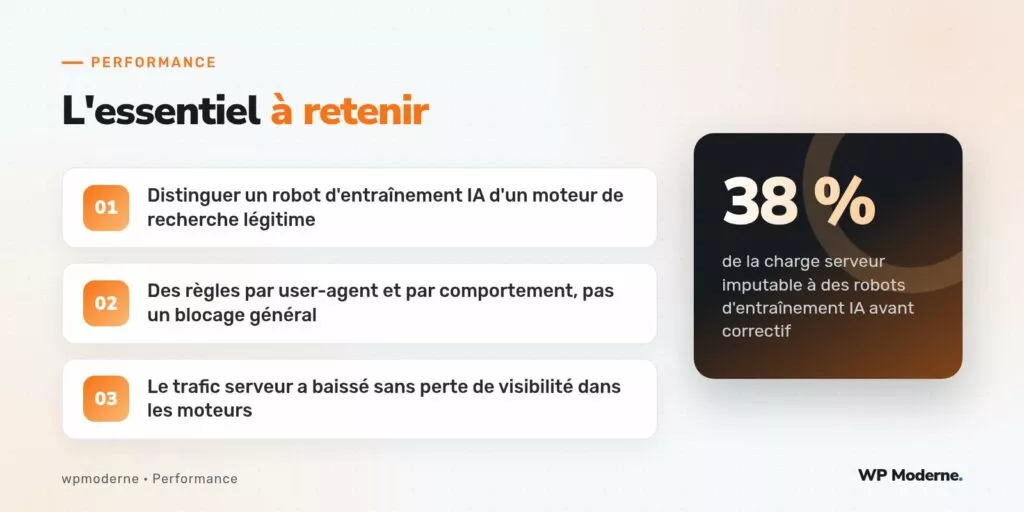
Un blocage de robots efficace se construit sur trois signaux combinés — user-agent déclaré, catégorisation vérifiée par le fournisseur, et comportement observé — jamais sur un seul d’entre eux.
Effet sur le référencement naturel
Un point de vigilance essentiel a consisté à vérifier, une semaine après la mise en place, que le volume de pages explorées par Googlebot et Bingbot dans Search Console et Bing Webmaster Tools n’avait pas varié. Ce fut le cas : la catégorisation Cloudflare distingue correctement les robots de recherche vérifiés des robots d’entraînement IA, même quand ces derniers partagent parfois une infrastructure réseau proche.
Résultat mesuré
| Indicateur | Avant | Après une semaine |
|---|---|---|
| Part de la charge serveur liée aux robots IA | 38 % | 3 % |
| Pages explorées par Googlebot (Search Console) | référence | stable, aucune baisse |
| Temps de réponse moyen sur le catalogue | 640 ms | 410 ms |
Pour aller plus loin
La liste des robots d’entraînement IA connus évolue vite, et une règle statique se périme. Cloudflare met à jour sa catégorisation automatiquement côté managed rules, ce qui évite d’avoir à surveiller manuellement l’apparition de nouveaux user-agents chaque mois. Le vrai travail reste, en amont, de bien vérifier que la règle appliquée cible une catégorie distincte des moteurs de recherche légitimes avant de l’activer en production.