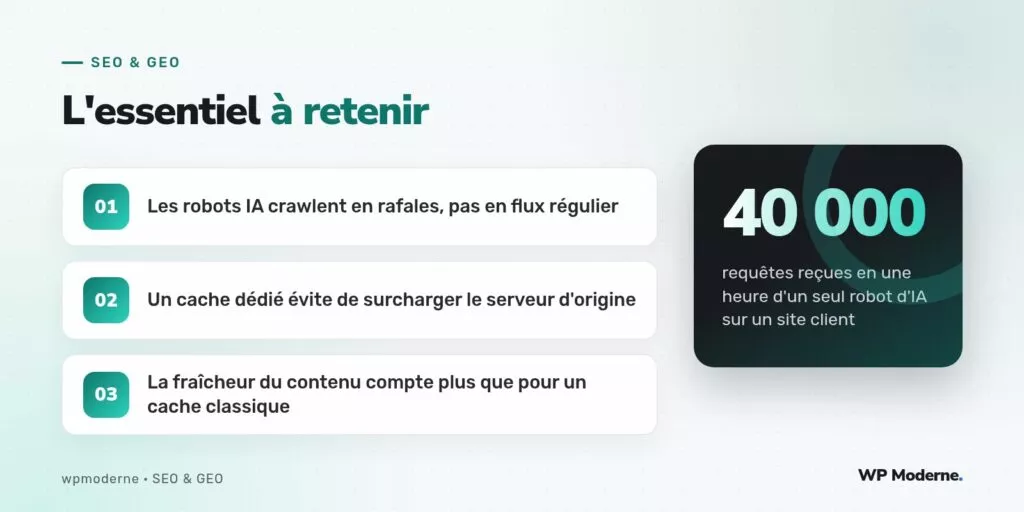
Un matin, l’équipe technique d’un site d’annonces immobilières nous a signalé un pic de charge serveur inexpliqué : plus de 40 000 requêtes en une heure, concentrées sur les pages de fiches de biens, provenant d’une poignée d’adresses IP identifiées comme appartenant à un robot d’exploration associé à un moteur de réponse générative. Le cache de page classique, pensé pour des visiteurs humains avec des sessions et des cookies, ne protégeait pas correctement le serveur contre ce type de trafic.
Ce cas a servi de point de départ à une réflexion plus large : une architecture de cache pensée pour les robots humains n’est pas nécessairement adaptée aux robots des moteurs de réponse, qui ont un comportement de crawl très différent. Voici l’arborescence retenue depuis pour ce type de site.
Ce qui distingue un robot IA d’un visiteur humain
- Il n’envoie jamais de cookies de session et ne déclenche donc aucune variante de cache liée à l’utilisateur connecté.
- Il crawle par rafales concentrées sur une période courte, plutôt qu’en flux régulier tout au long de la journée.
- Il n’exécute pas le JavaScript, ce qui rend inutile toute variante de cache liée à l’hydratation côté client.
- Il revient parfois avec une fréquence bien plus faible qu’un moteur de recherche classique, ce qui change les besoins en fraîcheur.
L’arborescence de cache retenue
Requête entrante
│
├── User-Agent identifié comme robot IA connu (liste maintenue)
│     │
│     ├── Page déjà en cache "robots" (TTL long, 24h)
│     │     └── Réponse servie depuis ce cache, sans toucher PHP/MySQL
│     │
│     └── Page absente du cache "robots"
│           └── Génération, mise en cache dédiée, réponse
│
└── User-Agent humain ou robot non identifié
      │
      ├── Cache de page standard (TTL court, 1h, variantes par device)
      └── Génération classique si absent
La séparation en deux caches distincts, avec des durées de vie différentes, part d’un constat simple : le contenu d’une fiche de bien immobilier ne change pas plusieurs fois par heure, mais un visiteur humain qui vient de contacter l’agence peut avoir besoin de voir une mise à jour de disponibilité plus rapidement qu’un robot qui repassera de toute façon dans la journée suivante.
Identifier les robots sans se fier uniquement au user-agent
Le user-agent déclaré reste la première source d’identification, mais il peut être falsifié ou simplement absent de la liste de référence tenue à jour. En complément, une règle basée sur le comportement (fréquence de requêtes depuis une même plage d’adresses IP, absence totale de cookies sur toute la session, absence d’en-tête Referer cohérent) permet de router vers le cache dédié même un robot mal identifié, par prudence, plutôt que de risquer une surcharge du serveur d’origine.
La question de la fraîcheur
Un cache trop long pénalise la citation : si un moteur de réponse génère sa base de connaissance à partir d’une version en cache vieille de plusieurs jours, il peut citer un prix ou une disponibilité qui n’existe plus. La solution retenue combine un TTL de 24 heures avec une invalidation ciblée : toute modification d’une fiche via l’administration WordPress déclenche, via le hook save_post, une purge immédiate de l’entrée correspondante dans le cache dédié aux robots, sans attendre l’expiration naturelle.
add_action( 'save_post_bien_immobilier', function ( $post_id ) {
    $cle_cache = 'cache_robots_' . $post_id;
    wp_cache_delete( $cle_cache, 'cache_robots_ia' );
}, 10, 1 );
Effet sur le serveur d’origine
| Indicateur | Avant l’architecture dédiée | Après |
|---|---|---|
| Charge serveur pendant un pic de crawl IA | CPU saturé, ralentissements pour les visiteurs humains | Charge stable, aucun impact visible |
| Taux de pages servies depuis le cache | Environ 30 % | Plus de 95 % pour le trafic identifié robot |
Le conseil qu’on donne systématiquement maintenant : ne jamais traiter le trafic des robots IA comme une variante mineure du trafic humain, mais comme une population avec ses propres règles de cache.
En résumé
Une architecture de cache dédiée aux robots des moteurs de réponse génératifs protège le serveur d’origine d’un trafic par rafales qu’un cache classique n’anticipe pas toujours, tout en gardant un contenu suffisamment frais pour rester fiable dans les réponses générées. Sur ce site d’annonces immobilières, le chantier a transformé un pic de charge redouté en non-événement, sans jamais sacrifier la justesse des informations citées.