Avant d’intégrer un générateur de contenu dans une extension WordPress destinée à nos clients, nous avons voulu chiffrer précisément ce que coûterait, à l’usage, chacune des trois API de LLM alors accessibles en self-service début 2023 : l’API GPT-3.5 Turbo et l’API GPT-4 d’OpenAI, ainsi que l’API Claude d’Anthropic (modèle Claude Instant).
Le test portait sur un cas concret : générer une introduction d’article de 150 mots à partir d’un titre et de trois mots-clés, répété sur cinquante titres différents issus de sites clients réels, afin de comparer coût, longueur effective et qualité perçue par notre équipe éditoriale.
Le protocole de mesure
Chaque titre a été soumis avec le même prompt aux trois API, via des appels wp_remote_post() depuis un script de test isolé, hors production. Nous avons enregistré pour chaque réponse le nombre de tokens facturés (en entrée et en sortie, tel que retourné par chaque API) et le coût réel calculé selon la grille tarifaire publique de chaque fournisseur au moment du test.
- GPT-3.5 Turbo : tarif le plus bas des trois, réponses rapides, ton parfois un peu plat
- GPT-4 : tarif nettement plus élevé, réponses plus nuancées et mieux structurées
- Claude Instant : tarif intermédiaire, bonne cohérence sur les textes longs
Ce que le prix au token ne dit pas
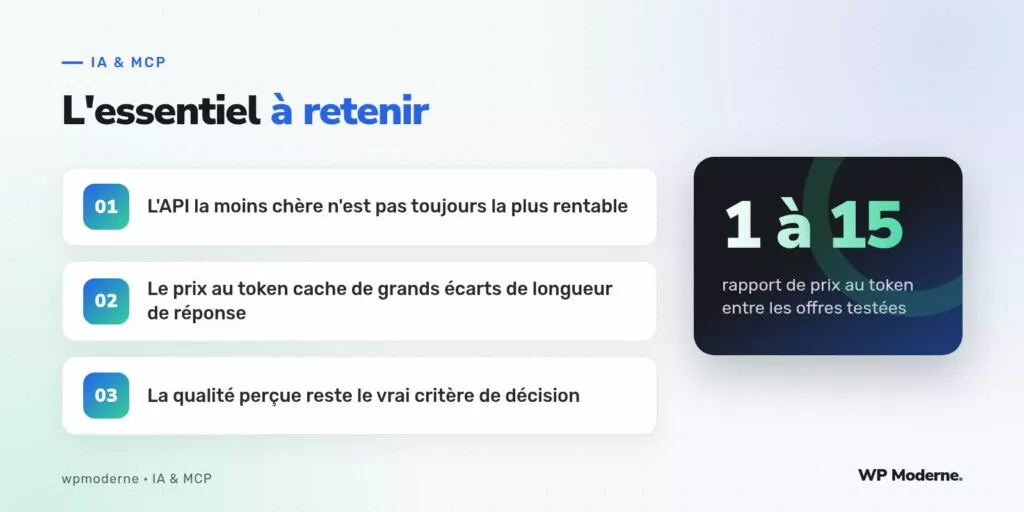
Le prix affiché par token est trompeur si on ne regarde pas la longueur réelle des réponses. Sur nos cinquante tests, GPT-4 produisait en moyenne des introductions 20 % plus longues que demandé quand le prompt restait vague, ce qui gonflait la facture au-delà du simple écart de tarif unitaire.
| API | Coût moyen par introduction | Longueur moyenne obtenue | Respect du format demandé |
|---|---|---|---|
| GPT-3.5 Turbo | ~0,0006 $ | 142 mots | Bon |
| GPT-4 | ~0,009 $ | 178 mots | Moyen (dépassements fréquents) |
| Claude Instant | ~0,0015 $ | 151 mots | Bon |
Ramené à un volume mensuel de 2 000 introductions générées, ce qui correspond au rythme d’un client publiant une quinzaine d’articles par jour sur plusieurs sites, l’écart de facture entre GPT-3.5 Turbo et GPT-4 dépassait un facteur de dix, pour un gain de qualité perceptible mais pas toujours déterminant sur ce cas d’usage précis.
La qualité perçue, notée à l’aveugle
Nous avons soumis les 150 textes générés (50 par API) à deux rédacteurs de notre équipe, sans leur indiquer quelle API avait produit quel texte, avec une notation simple de 1 à 5 sur la pertinence et le naturel du style. GPT-4 est arrivé en tête avec une moyenne de 4,1, suivi de Claude Instant à 3,6, puis GPT-3.5 Turbo à 3,3.
Sur un usage à fort volume et faible enjeu éditorial, comme une introduction générique, l’écart de qualité entre les trois API pèse souvent moins lourd que l’écart de facture.
Ce que nous avons retenu pour l’extension
Nous avons choisi GPT-3.5 Turbo comme moteur par défaut, avec la possibilité pour le client de basculer vers GPT-4 sur les contenus jugés stratégiques (pages piliers, argumentaires commerciaux), moyennant un paramètre de configuration exposé dans les réglages de l’extension. Ce compromis évite de payer le tarif le plus élevé sur des textes à faible enjeu, tout en gardant l’option premium disponible.
Nous avons également ajouté un plafond de tokens en sortie dans chaque appel, pour éviter les dépassements de longueur constatés avec GPT-4 lorsque le prompt restait imprécis.
La latence, un critère souvent oublié
Au-delà du prix et de la qualité perçue, nous avons aussi chronométré le temps de réponse moyen de chaque API sur nos cinquante requêtes. GPT-3.5 Turbo répondait en une seconde et demie en moyenne, Claude Instant autour de deux secondes, et GPT-4 dépassait régulièrement les quatre secondes. Sur une extension destinée à générer une introduction pendant que le rédacteur patiente devant son écran d’édition, cet écart de latence pèse directement sur le confort d’usage perçu, indépendamment même du coût facturé.
En résumé
Le prix affiché au token ne suffit pas à comparer des API de génération de contenu : la longueur réelle des réponses, la latence de réponse et le respect du format demandé changent significativement la facture finale et l’expérience d’usage. Sur un usage à fort volume et enjeu éditorial modéré, l’API la moins chère reste souvent le choix le plus rentable, à condition de réserver les modèles plus coûteux aux contenus qui justifient réellement l’écart de qualité.