Il y a un an, nous avions publié un premier comparatif sur la capacité des modèles de langage à générer du code WordPress fiable, avec des résultats mitigés : hooks inventés, fonctions dépréciées suggérées sans avertissement, standards de codage ignorés. Cette mise à jour reprend exactement les mêmes critères, sur les versions les plus récentes disponibles des trois familles de modèles, pour mesurer ce qui a réellement progressé.
Cet article ne traite pas les questions de tarification ni de facturation des API, abordées séparément ailleurs sur ce blog : il se concentre uniquement sur la qualité et l’exactitude du code produit.
Méthode de test reconduite à l’identique
Nous avons repris le même protocole que l’an dernier : une série de vingt requêtes de génération de code couvrant des cas courants (ajout d’un champ dans l’éditeur, enregistrement d’un type de contenu personnalisé, hook sur la publication d’un article) et des cas plus pièges (fonctions proches par le nom, hooks dépréciés depuis une version récente, usage correct de wp_enqueue_script avec ses dépendances).
Invention de fonctions et de hooks
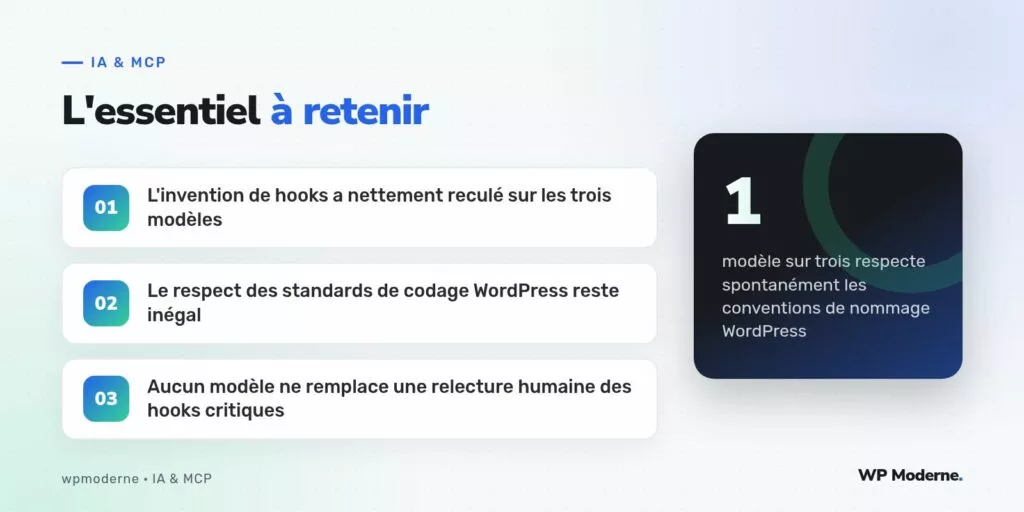
C’est le point où le progrès est le plus net. L’an dernier, sur nos vingt requêtes, chaque modèle produisait au moins un hook ou une fonction inexistante, généralement plausible par son nom mais absente du codex WordPress. Cette année, sur le même jeu de test, ce taux a nettement baissé pour les trois modèles, sans toutefois disparaître complètement sur les cas les plus pièges, en particulier les hooks similaires introduits sur des versions proches l’une de l’autre.
- Les confusions les plus fréquentes concernent encore des hooks au nom très proche (préfixe identique, suffixe différent) réellement présents dans des versions différentes de WordPress ou de WooCommerce.
- Aucun des trois modèles ne signale spontanément l’incertitude quand il n’est pas sûr qu’un hook existe : il faut explicitement le demander dans le prompt pour obtenir une réserve.
Respect des standards de codage WordPress
Sur l’indentation, le nommage des fonctions en snake_case préfixé, et l’échappement systématique des sorties (esc_html(), esc_attr()), les résultats restent inégaux d’un modèle à l’autre. Un modèle applique ces conventions de façon quasi systématique dès la première génération, sans qu’on ait besoin de les rappeler dans le prompt. Les deux autres les respectent surtout quand on les mentionne explicitement, et retombent parfois dans des conventions plus génériques (camelCase, absence d’échappement) sur des exemples de code plus longs.
| Critère observé | Évolution sur un an |
|---|---|
| Hooks inventés | Nette baisse, cas résiduels sur hooks proches |
| Échappement des sorties | Amélioré, encore inégal sans rappel explicite |
| Nommage snake_case préfixé | Un modèle systématique, deux inconstants |
| Signalement de l’incertitude | Toujours absent sans demande explicite |
Un cas concret qui persiste
Sur la requête « ajoute un hook pour valider un champ personnalisé avant l’enregistrement d’un article », deux modèles sur trois ont encore proposé une variante de save_post sans vérifier wp_is_post_revision() ni retirer temporairement le hook pour éviter une boucle infinie lors de la mise à jour programmatique du post — un piège classique que nous retrouvons année après année, quel que soit le modèle testé.
Le progrès est réel sur l’invention pure de fonctions. Il l’est beaucoup moins sur les pièges structurels classiques de l’API WordPress, qui demandent de comprendre l’ordre d’exécution, pas seulement de connaître le nom d’une fonction.
Ce qui n’a pas changé
Aucun des trois modèles ne remplace une relecture humaine sur du code touchant à la sécurité ou à des hooks critiques du cycle de publication. La différence avec l’an dernier n’est pas qualitative sur ce point : elle est quantitative, avec moins d’erreurs grossières, mais un besoin de vérification qui reste entier sur le code destiné à la production.
Notre verdict
Le principal progrès observé cette année porte sur la réduction des hooks purement inventés, ce qui limite un risque très visible. Le risque plus insidieux — un code syntaxiquement correct mais qui ignore l’ordre d’exécution ou les cas limites de l’API WordPress — reste comparable à l’an dernier. Nous continuons donc à recommander une revue systématique du code généré avant toute mise en production, quel que soit le modèle utilisé.