Zabbix, installé en premier pour la supervision d’infrastructure. Puis Uptime Kuma, ajouté pour un contrôle de disponibilité plus visuel. Puis un agent New Relic, activé temporairement pour diagnostiquer un ralentissement précis. Puis Sentry, pour les erreurs applicatives. Puis un script maison qui envoie des alertes par email. Puis, enfin, un tableau de bord Grafana censé tout regrouper, mais qui ne fait qu’ajouter une septième source de vérité à consulter. Ce billet ne recommande aucun de ces outils en particulier : il décrit un antipattern qui touche la plupart des équipes qui gèrent un parc de serveurs WordPress dans la durée.
Le point commun de tous ces outils : chacun a été ajouté pour résoudre un problème précis, à un moment précis, sans jamais retirer ceux qui l’avaient précédé. Deux ans plus tard, le parc dispose de six systèmes de supervision actifs simultanément, dont la moitié génère des alertes redondantes, et personne ne sait plus exactement lequel consulter en priorité lors d’un incident.
Ce qu’on observe
Le symptôme le plus visible est la multiplication des canaux d’alerte : une même panne de disque plein génère une notification Zabbix, une alerte Uptime Kuma sur l’indisponibilité du site qui en résulte, et un message du script maison qui surveille l’espace disque de façon indépendante. Trois alertes pour un seul incident, envoyées sur des canaux différents, à des horaires légèrement décalés selon la fréquence de sondage de chaque outil.
Un second symptôme, plus insidieux, concerne la confiance progressivement perdue dans le système d’alerte. Quand une alerte sur trois s’avère être un doublon ou un faux positif généré par un outil dont plus personne ne maîtrise vraiment la configuration, l’équipe finit par filtrer mentalement les notifications plutôt que d’agir sur chacune, ce qui revient, dans les faits, à annuler l’intérêt même de la supervision.
Pourquoi c’est un problème
Chaque outil ajouté représente un coût qui ne disparaît jamais de lui-même : une configuration à maintenir, des identifiants d’accès à gérer, une version à mettre à jour, et une charge cognitive supplémentaire pour quiconque doit diagnostiquer un incident en pleine nuit. Ce coût ne se voit pas au moment de l’ajout, puisque l’outil résout alors un vrai problème ponctuel. Il apparaît progressivement, sous forme de dette de supervision, quand personne ne sait plus expliquer pourquoi tel outil est encore actif ni ce qu’il apporte réellement par rapport aux autres.
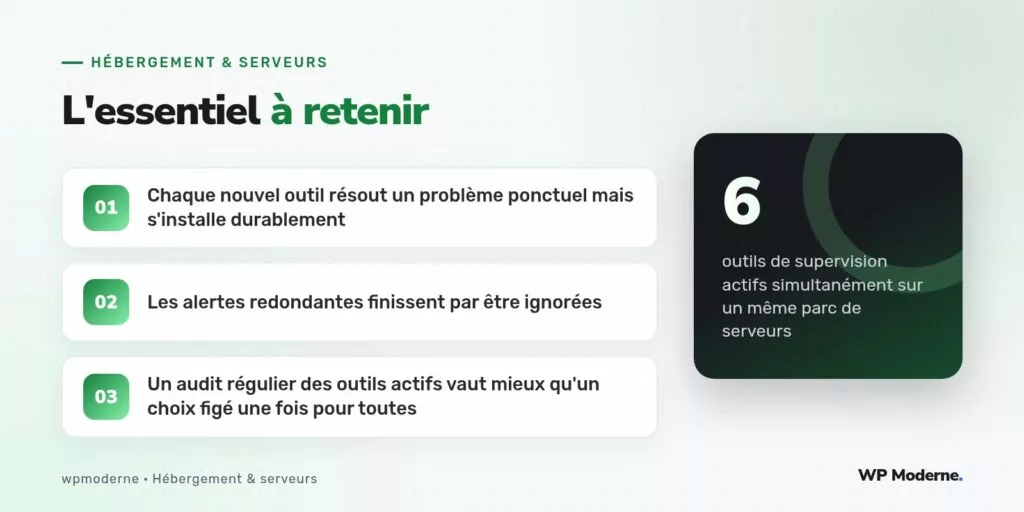
Un autre effet pervers concerne la surface d’attaque du parc. Chaque agent de supervision installé sur un serveur constitue un point d’accès supplémentaire, avec ses propres identifiants, ses propres droits, et sa propre fréquence de mise à jour de sécurité. Six outils de supervision, c’est potentiellement six surfaces d’exposition distinctes à surveiller, alors qu’un seul système bien configuré suffirait à couvrir le même périmètre fonctionnel.
Ce qu’on voit sur le terrain
- Des tableaux de bord Grafana avec des sources de données pointant vers des serveurs Zabbix qui ne remontent plus d’informations depuis des mois, sans que personne ne l’ait remarqué.
- Des règles d’alerte dupliquées entre deux outils différents, avec des seuils légèrement différents, qui déclenchent des notifications à quelques minutes d’écart pour le même événement.
- Des scripts maison de supervision écrits par un développeur qui a quitté l’équipe depuis, que personne n’ose désactiver de peur qu’ils couvrent un cas non documenté ailleurs.
Quoi faire
La réponse ne consiste pas à choisir un outil unique et définitif, une décision qui finit toujours par être remise en cause par un besoin futur légitime. Elle consiste plutôt à instaurer un audit périodique, par exemple deux fois par an, qui répond à trois questions simples pour chaque outil actif :
- Cet outil couvre-t-il un périmètre que ne couvre déjà pas un autre outil du parc ?
- Quelqu’un dans l’équipe sait-il encore configurer et faire évoluer cet outil sans devoir tout redécouvrir ?
- Les alertes qu’il génère sont-elles effectivement consultées et suivies d’une action, ou finissent-elles systématiquement ignorées ?
Un outil qui échoue aux trois questions devient un candidat sérieux à la suppression, pas à la simple mise en veille, qui laisse traîner une dette identique sous une forme légèrement différente.
Retirer un outil de supervision demande plus de courage que d’en ajouter un : il faut assumer qu’un périmètre de surveillance change, et documenter clairement pourquoi.
En résumé
La supervision d’un parc de serveurs WordPress ne s’améliore pas nécessairement en ajoutant des outils : elle se dégrade souvent en en accumulant sans jamais faire le tri. Un audit périodique, qui questionne l’utilité réelle de chaque système actif plutôt que sa seule présence historique, évite que le tableau de bord censé protéger le parc ne devienne lui-même une source de confusion lors d’un incident.