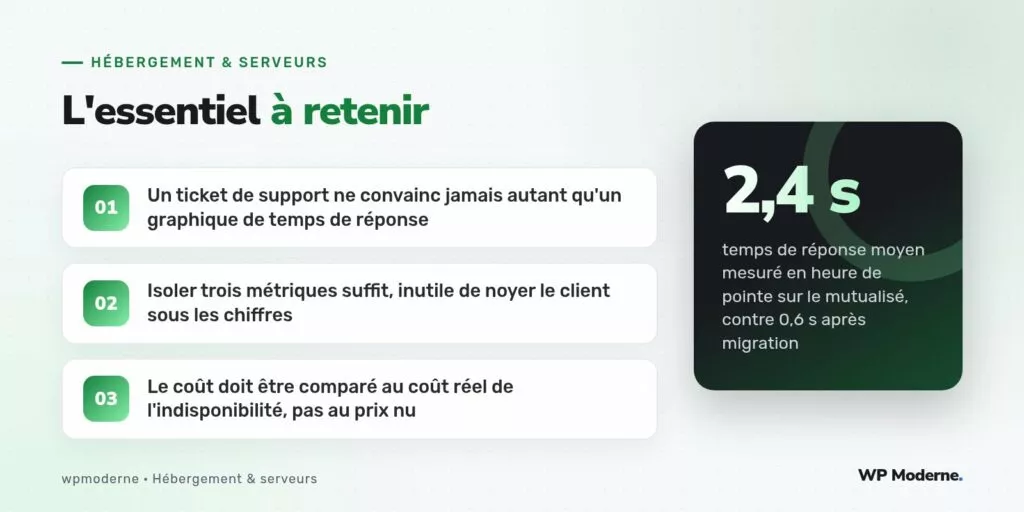
$ curl -o /dev/null -s -w "%{time_total}\n" https://exemple-client.fr/ renvoyait 2,4 secondes en moyenne aux heures de forte affluence sur l’hébergement mutualisé du client, contre 0,6 seconde une fois la migration effectuée vers un serveur dédié. Ce billet ne traite pas du choix du fournisseur du serveur dédié lui-même, une décision distincte, mais de la façon dont ces chiffres ont été présentés pour convaincre un client historiquement réticent à toute augmentation de budget d’hébergement.
Le client en question gérait une boutique en ligne WordPress dont le trafic avait progressivement doublé en dix-huit mois, sans qu’aucun changement d’infrastructure n’ait accompagné cette croissance. Chaque proposition de montée en gamme avait jusque-là été refusée, le mutualisé actuel étant perçu comme suffisant tant que le site restait globalement accessible.
Le problème de l’argumentation initiale, trop qualitative
Les premières tentatives d’argumentation reposaient sur des formulations générales : « le site est lent », « les performances se dégradent », « il faudrait passer à quelque chose de plus robuste ». Ce type de discours, sans données précises à l’appui, laissait toujours au client la possibilité de relativiser le problème, en particulier parce que le site restait techniquement accessible la majorité du temps, ce qui donnait l’impression trompeuse que la situation était sous contrôle.
Le changement de stratégie a consisté à remplacer ces formulations qualitatives par trois métriques précises, mesurées sur plusieurs semaines, et présentées sous forme de graphique plutôt que de tableau brut de chiffres.
Première métrique : le temps de réponse en heure de pointe
La première mesure a consisté à isoler le temps de réponse du serveur uniquement pendant les créneaux de trafic maximal, entre 18 heures et 20 heures en semaine, plutôt que sur une moyenne globale qui aurait dilué le problème dans des heures creuses peu représentatives. Cette mesure, effectuée pendant trois semaines consécutives avec un script simple exécuté toutes les cinq minutes, a montré une dégradation régulière et prévisible du temps de réponse à chaque pic de trafic, passant de 0,8 seconde en heure creuse à 2,4 secondes en heure de pointe.
Deuxième métrique : le taux d’erreurs 503 pendant les pics
La seconde mesure a porté sur le taux d’erreurs serveur retournées aux visiteurs, extrait des journaux d’accès nginx du mutualisé sur la même période :
awk '{print $9}' access.log | sort | uniq -c | sort -rn | head -5
   184392 200
     2103 503
      891 404
      212 301
       47 500
Plus de deux mille requêtes ayant reçu une erreur 503, « service temporairement indisponible », sur trois semaines, concentrées presque exclusivement sur les créneaux de pic identifiés précédemment. Ce chiffre, converti en équivalent de commandes potentiellement perdues sur une boutique en ligne, a eu un impact bien plus direct sur la décision du client que n’importe quelle description qualitative de lenteur.
Troisième métrique : le coût réel de l’indisponibilité
La dernière étape a consisté à croiser ces deux mesures techniques avec le panier moyen de la boutique et son taux de conversion habituel, pour estimer un ordre de grandeur du chiffre d’affaires potentiellement perdu sur la période observée. Ce calcul, volontairement prudent et présenté comme une estimation basse, a permis de comparer le coût mensuel supplémentaire d’un serveur dédié non plus au prix nu de l’offre mutualisée, mais au coût estimé de l’indisponibilité déjà subie.
- Coût mensuel du mutualisé actuel : montant de référence, connu du client.
- Coût mensuel estimé du serveur dédié envisagé : environ trois fois supérieur.
- Estimation basse du chiffre d’affaires perdu sur les pics de trois semaines observées : supérieure à la différence de coût sur plusieurs mois d’hébergement dédié.
Présentée sous cet angle, la décision n’apparaissait plus comme une dépense supplémentaire mais comme un investissement dont le retour se mesurait en semaines, pas en années.
Ce que la migration a effectivement changé
Une fois la migration réalisée, le suivi des mêmes métriques sur le nouveau serveur dédié a confirmé la disparition quasi totale des erreurs 503 et un temps de réponse stable, y compris pendant les pics de trafic identifiés précédemment. Ce suivi post-migration a également servi d’argument pour de futures discussions avec ce même client, en montrant concrètement que les chiffres présentés en amont s’étaient vérifiés après coup.
Un client convaincu par des chiffres reste convaincu longtemps ; un client convaincu par une impression de lenteur redemandera une preuve à la moindre remise en question.
En résumé
Convaincre un client réticent de passer d’un mutualisé à un serveur dédié ne repose pas sur la conviction technique du prestataire, mais sur des métriques précises, mesurées sur une période représentative et traduites en un impact business compréhensible sans expertise technique. Trois indicateurs suffisent généralement : le temps de réponse aux heures de pointe, le taux d’erreurs serveur, et une estimation prudente du coût de l’indisponibilité déjà subie.