Le cluster synchrone était en place depuis plusieurs mois : un nœud principal MariaDB, un nœud secondaire répliqué en temps réel, capable de prendre le relais en cas de panne. Mais lors du dernier incident réel, la bascule a pris près de quatre minutes, le temps qu’un administrateur d’astreinte reçoive l’alerte, se connecte, vérifie l’état du cluster et promeuve manuellement le nœud secondaire. Pour un client dont le contrat prévoit une disponibilité proche du temps réel sur sa boutique en ligne, quatre minutes d’indisponibilité représentent des commandes perdues et un climat de confiance écorné.
La mise en place du cluster répliqué avait déjà été traitée l’an dernier sur ce site. Ce qui manquait, c’était l’outillage de décision et de bascule automatique : détecter la panne, décider qu’elle est réelle (et non un simple faux positif réseau), promouvoir le bon nœud, et rebrancher l’application sans qu’un humain n’ait à taper la moindre commande.
Pourquoi la réplication seule ne suffit pas
Un cluster répliqué répond à la question « où sont les données de secours », mais pas à la question « qui décide et quand de basculer ». Sans outil dédié, cette décision reste humaine : quelqu’un doit constater la panne, vérifier qu’elle n’est pas transitoire, choisir le bon nœud à promouvoir (celui dont les données sont les plus à jour), puis reconfigurer l’application pour qu’elle pointe vers le nouveau nœud principal. Chacune de ces étapes prend du temps et est sujette à l’erreur humaine sous pression.
MHA et Orchestrator : deux approches du même problème
Deux outils dominent ce terrain pour MariaDB et MySQL : MHA (Master High Availability), plus ancien, orienté ligne de commande et scripts Perl, et Orchestrator, plus récent, avec une interface web de topologie et une détection de panne plus fine basée sur un consensus entre plusieurs nœuds observateurs. Le choix pour ce projet s’est porté sur Orchestrator, notamment pour sa capacité à distinguer une vraie panne d’un simple problème réseau localisé grâce à sa détection par consensus.
| Critère | MHA | Orchestrator |
|---|---|---|
| Interface | Ligne de commande uniquement | Interface web de topologie |
| Détection de panne | Simple, un seul observateur | Par consensus entre plusieurs nœuds |
| Maintenance du projet | Ralentie ces dernières années | Activement maintenu |
Mise en place d’Orchestrator
Orchestrator s’installe sur une machine distincte des nœuds MariaDB, idéalement en plusieurs instances réparties pour éviter qu’il devienne lui-même un point de panne unique. Chaque instance surveille la topologie via un compte MySQL dédié à droits limités :
-- Compte de supervision créé sur chaque nœud MariaDB
CREATE USER 'orchestrator'@'%' IDENTIFIED BY 'mot-de-passe-fort';
GRANT SUPER, PROCESS, REPLICATION SLAVE, REPLICATION CLIENT,
      RELOAD ON *.* TO 'orchestrator'@'%';
GRANT SELECT ON mysql.* TO 'orchestrator'@'%';
Une fois connecté à la topologie, Orchestrator détecte automatiquement la relation principal/réplicas et l’affiche dans son interface. La configuration orchestrator.conf.json définit les seuils de détection de panne, le comportement de promotion souhaité (quel réplica privilégier si plusieurs sont candidats), et surtout le hook exécuté après une bascule réussie.
Rebrancher l’application après bascule
La bascule de la base ne sert à rien si WordPress continue de pointer vers l’ancien nœud principal devenu inaccessible. Le hook post-bascule d’Orchestrator déclenche typiquement une modification d’un enregistrement DNS interne ou d’un VIP (adresse IP virtuelle) que WordPress cible dans sa configuration de connexion base de données, plutôt que de coder en dur l’adresse du nœud principal.
- Utiliser un nom DNS interne ou un VIP comme cible de connexion dans
wp-config.php, jamais l’IP fixe d’un nœud particulier. - Le hook de bascule met à jour cette cible immédiatement après la promotion du nouveau nœud principal.
- Un court délai de purge de cache DNS côté application doit être anticipé pour éviter que les connexions existantes ne pointent encore vers l’ancien nœud.
Le risque de split-brain
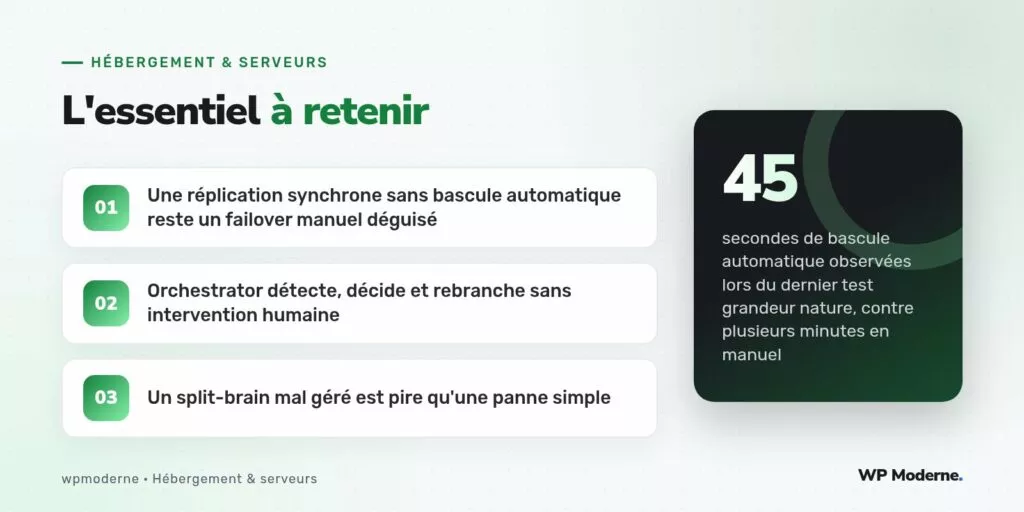
Le danger principal d’un failover automatique mal réglé est le split-brain : deux nœuds qui se croient tous les deux principaux simultanément, chacun acceptant des écritures, avec un risque de divergence de données quasi impossible à réconcilier proprement ensuite. Orchestrator limite ce risque via sa détection par consensus (plusieurs observateurs doivent s’accorder sur la panne avant de déclencher une promotion) et via un mécanisme de dégradation en lecture seule de l’ancien nœud principal dès qu’il redevient joignable après une bascule.
Un failover automatique mal testé est plus dangereux qu’un failover manuel : mieux vaut une bascule lente mais sûre qu’une bascule rapide qui divise le cluster en deux vérités concurrentes.
Tester avant de faire confiance
Aucune mise en place de failover automatique ne mérite confiance sans un test grandeur nature en conditions réalistes : coupure brutale du nœud principal en dehors des heures de fort trafic, mesure du temps de bascule réel, vérification que l’application reprend correctement les écritures sur le nouveau nœud. Sur ce projet, le test a mesuré une bascule complète en 45 secondes, du moment de la panne simulée jusqu’à la reprise effective des écritures WordPress.
En résumé
Passer d’un cluster MariaDB simplement répliqué à un cluster à bascule automatique change fondamentalement le temps de reprise en cas de panne : de plusieurs minutes dépendantes d’une intervention humaine à moins d’une minute pilotée par un outil comme Orchestrator. Le vrai travail ne s’arrête pas à l’installation : il se poursuit par le rebranchement propre de l’application via DNS ou VIP, et par des tests réguliers en conditions réelles pour écarter tout risque de split-brain.



