Trois secondes de coupure réseau sur un point d’accès mobile, et c’est un panier d’achat qui se vide côté front, ou une fiche produit qui n’affiche jamais son image faute d’avoir pu récupérer la réponse de /wp/v2/media. Sur un front très découplé qui multiplie les appels vers l’API REST de WordPress, une coupure réseau ponctuelle — loin d’être rare sur mobile — provoque un échec de requête que la plupart des implémentations naïves ne rattrapent jamais.
Ce tutoriel construit, étape par étape, un intercepteur HTTP capable de rejouer automatiquement une requête échouée pour une cause réseau, sans intervention de l’utilisateur ni rechargement de page.
Étape 1 : distinguer erreur réseau et erreur applicative
Toutes les requêtes échouées ne méritent pas d’être rejouées. Une erreur 404 (contenu introuvable) ou 403 (accès refusé) restera identique à la deuxième tentative : la rejouer ne sert à rien et masque un vrai problème. Seules les erreurs réseau (la requête n’atteint jamais le serveur) ou certaines erreurs serveur temporaires (503, souvent liée à une surcharge momentanée) justifient une nouvelle tentative.
function estUneErreurRejouable(erreur, reponse) {
  if (erreur) {
    // Erreur réseau : fetch() a levé une exception, aucune réponse reçue
    return true;
  }
  return reponse.status === 503 || reponse.status === 502;
}
Étape 2 : écrire la fonction de nouvelle tentative
La fonction encapsule fetch() et rejoue la requête un nombre limité de fois, avec un délai qui augmente à chaque tentative (une pratique connue sous le nom d’attente exponentielle) :
async function requeteAvecReprise(url, options = {}, tentativesMax = 3) {
  let derniereErreur;

  for (let tentative = 0; tentative < tentativesMax; tentative++) {
    try {
      const reponse = await fetch(url, options);

      if (reponse.ok) {
        return reponse;
      }

      if (!estUneErreurRejouable(null, reponse) || tentative === tentativesMax - 1) {
        return reponse;
      }
    } catch (erreur) {
      derniereErreur = erreur;
      if (tentative === tentativesMax - 1) {
        throw derniereErreur;
      }
    }

    const delai = 500 * Math.pow(2, tentative);
    await new Promise((resoudre) => setTimeout(resoudre, delai));
  }
}
Avec trois tentatives et un délai de base de 500 millisecondes, les pauses entre tentatives s’étalent à 500 ms, puis 1 seconde, puis 2 secondes : suffisant pour laisser passer la plupart des coupures ponctuelles, sans faire attendre l’utilisateur au-delà de quelques secondes au total.
Étape 3 : brancher l’intercepteur sur les appels REST du front
Plutôt que d’appeler fetch() directement dans chaque composant du front, centraliser tous les appels vers l’API WordPress à travers cette fonction garantit une résilience homogène sur l’ensemble de l’application :
async function appelerApiWordpress(chemin) {
  const reponse = await requeteAvecReprise(`https://mon-site.example.com/wp-json${chemin}`);
  if (!reponse.ok) {
    throw new Error(`Erreur API : ${reponse.status}`);
  }
  return reponse.json();
}
Étape 4 : ne jamais rejouer une requête qui modifie des données
Rejouer automatiquement une requête GET ne présente aucun risque, puisqu’elle ne modifie rien côté serveur. Une requête POST vers une route d’écriture (par exemple l’ajout d’un commentaire via l’API REST) pose un problème différent : si la première tentative a réussi côté serveur mais que la réponse s’est perdue en chemin, une nouvelle tentative créerait un doublon. Pour ces requêtes, la reprise automatique doit être désactivée, ou accompagnée d’une clé d’idempotence transmise dans l’en-tête de la requête, que le serveur peut reconnaître pour ignorer un doublon.
Étape 5 : informer l’utilisateur sans le bloquer
Pendant les tentatives de reprise, l’interface ne doit pas rester figée sans explication. Un indicateur discret (« Reconnexion en cours… ») rassure l’utilisateur sans provoquer d’inquiétude excessive pour une coupure de quelques secondes seulement, tout en laissant place à un message d’erreur clair si la troisième tentative échoue également.
En résumé
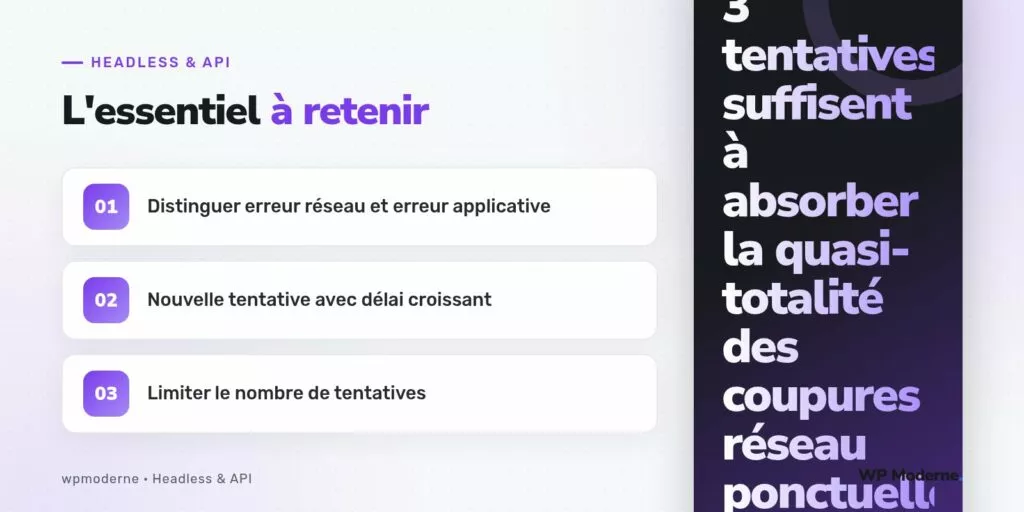
Un intercepteur de reprise automatique n’a pas besoin d’être complexe pour couvrir l’essentiel des coupures réseau ponctuelles rencontrées par un front headless. Trois tentatives avec un délai croissant suffisent dans la grande majorité des cas, à condition de réserver cette mécanique aux requêtes de lecture et aux erreurs réellement transitoires, jamais aux erreurs applicatives qui resteront identiques quel que soit le nombre de tentatives effectuées.