Un champ recalculé à chaque requête ressemble, à première vue, à une garantie de fraîcheur sans compromis : la donnée renvoyée reflète toujours l’état actuel du contenu, sans risque de valeur périmée. Face à lui, un champ précalculé et stocké en base au moment de la sauvegarde de l’article semble plus rapide à lire, mais expose au risque d’afficher une valeur devenue fausse si un élément externe au contenu lui-même a changé entre-temps.
Ce choix, loin d’être anodin, mérite d’être posé consciemment pour chaque champ ajouté à une réponse REST via register_rest_field(), plutôt que tranché par habitude ou par défaut technique.
Le champ calculé à la volée
Un champ comme le nombre d’articles liés à une même catégorie, ou le temps de lecture estimé d’un texte, se prête bien au calcul à chaque requête : le coût de calcul reste faible, et la donnée doit rester exacte à l’instant de la lecture.
register_rest_field( 'post', 'nombre_articles_categorie', array(
    'get_callback' => function( $post ) {
        $termes = wp_get_post_terms( $post['id'], 'category', array( 'fields' => 'ids' ) );
        if ( empty( $termes ) ) {
            return 0;
        }
        $requete = new WP_Query( array(
            'category__in'   => $termes,
            'posts_per_page' => 1,
            'fields'         => 'ids',
        ) );
        return (int) $requete->found_posts;
    },
) );
Sur une route de détail (un seul article), ce coût reste négligeable. Sur une route de liste renvoyant cinquante articles, ce même calcul s’exécute cinquante fois, ce qui peut significativement ralentir la réponse.
Le champ précalculé et stocké
Pour ce même type de champ, une alternative consiste à calculer la valeur une seule fois, au moment de la sauvegarde de l’article ou de la mise à jour de ses catégories, puis à la stocker en tant que métadonnée, lue directement sans recalcul :
add_action( 'save_post', function( $post_id ) {
    $termes = wp_get_post_terms( $post_id, 'category', array( 'fields' => 'ids' ) );
    $compteur = count( $termes ) ? ( new WP_Query( array(
        'category__in'   => $termes,
        'posts_per_page' => 1,
        'fields'         => 'ids',
    ) ) )->found_posts : 0;

    update_post_meta( $post_id, '_nombre_articles_categorie', $compteur );
} );

register_rest_field( 'post', 'nombre_articles_categorie', array(
    'get_callback' => function( $post ) {
        return (int) get_post_meta( $post['id'], '_nombre_articles_categorie', true );
    },
) );
Le piège de la valeur stockée : la désynchronisation
Le champ stocké ne se recalcule que lorsque l’article concerné est lui-même sauvegardé. Si un autre article de la même catégorie est publié ou supprimé, le compteur stocké sur les articles déjà existants ne se met pas à jour automatiquement, sauf à prévoir explicitement un hook supplémentaire qui recalcule les compteurs de tous les articles de la catégorie concernée à chaque changement — ce qui peut vite devenir plus coûteux que le calcul à la volée qu’on cherchait justement à éviter.
Un critère de décision simple : le ratio lecture/écriture
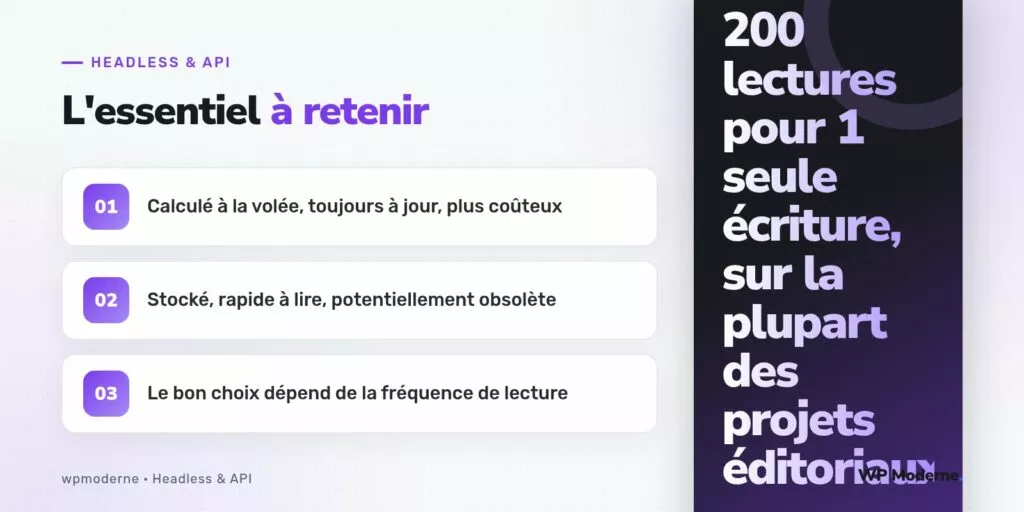
Sur la plupart des projets éditoriaux, un contenu est modifié une poignée de fois après sa publication, mais lu des centaines de fois par des visiteurs et par le front qui interroge l’API. Ce déséquilibre, souvent de l’ordre de 200 lectures pour une seule écriture, penche naturellement en faveur du stockage précalculé pour tout champ dont le calcul reste coûteux, à condition d’accepter une fraîcheur légèrement décalée par rapport à l’instant exact de la lecture.
- Calcul léger et donnée qui doit rester exacte à la seconde près : calcul à la volée.
- Calcul coûteux et tolérance à un léger décalage de fraîcheur : stockage précalculé.
- Donnée qui dépend d’éléments externes à l’article lui-même (autres contenus, service tiers) : stockage précalculé avec un mécanisme explicite de recalcul déclenché par les événements pertinents.
Verdict argumenté
Aucune des deux approches ne l’emporte dans l’absolu : le calcul à la volée garantit l’exactitude au prix d’une charge serveur variable selon le volume de la réponse, tandis que le stockage précalculé garantit une lecture rapide au prix d’une fraîcheur qui dépend de la rigueur des hooks de recalcul mis en place. Le bon compromis se choisit champ par champ, en évaluant à la fois le coût réel du calcul et la fréquence à laquelle la donnée sous-jacente change réellement.