Zéro milliseconde de marge : c’est ce que laisse un worker PHP-FPM tué en pleine écriture pour terminer proprement son travail. Une suite de tests qui ne couvre que des requêtes menées jusqu’à leur terme normal ne dit absolument rien de ce qui se passe dans ce cas précis, quand le processus s’arrête net en plein milieu d’une opération de plusieurs écritures.
Le cas concret ici : une extension de gestion de commandes qui écrit d’abord la commande elle-même, puis décrémente le stock, puis envoie une notification, dans trois requêtes successives sans transaction englobante unique. Le chemin heureux fonctionnait parfaitement en test. Personne n’avait jamais vérifié ce qui se produisait si le processus s’arrêtait entre la première et la deuxième écriture.
Pourquoi le chemin heureux ne suffit jamais à évaluer la résilience
Un test classique lance une requête, attend sa réponse complète, et vérifie le résultat final. Ce déroulement ne ressemble en rien à ce qui se produit lors d’un redémarrage de serveur, d’une limite de mémoire atteinte par un worker, ou d’un dépassement du temps maximal d’exécution configuré. Dans ces situations réelles, le processus s’arrête à un point arbitraire de son exécution, potentiellement entre deux écritures censées rester cohérentes entre elles.
Provoquer l’interruption à un point précis et reproductible
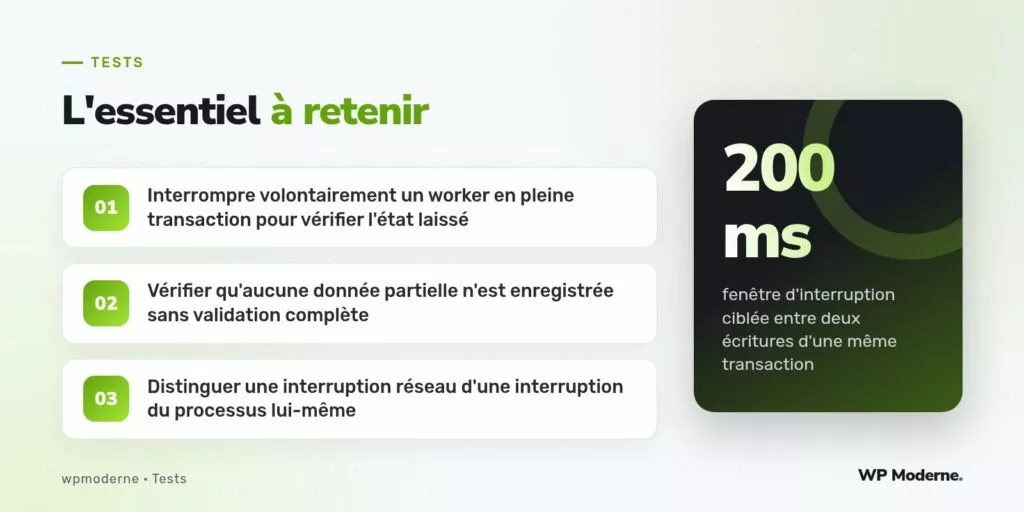
L’objectif n’est pas de tuer le worker au hasard, ce qui produirait des résultats trop variables pour être exploitables, mais de cibler précisément le point d’interruption entre deux opérations connues. Un script de test place un point d’arrêt temporaire dans le code, activé uniquement dans un environnement de test dédié :
if ( defined( 'TEST_RESILIENCE_POINT_ARRET' )
    && TEST_RESILIENCE_POINT_ARRET === 'apres_creation_commande' ) {
    posix_kill( getmypid(), SIGKILL );
}
Ce point d’arrêt, protégé par une constante définie uniquement dans l’environnement de test, provoque l’interruption exactement entre la création de la commande et la décrémentation du stock, reproduisant fidèlement le scénario redouté.
Vérifier l’état laissé après l’interruption
Une fois le worker interrompu, un second script, exécuté après le redémarrage automatique du gestionnaire de processus, interroge l’état de la base de données pour vérifier qu’aucune incohérence durable ne subsiste :
wp eval '
$commande = wc_get_order( $id_commande_test );
if ( $commande && $commande->get_status() === "en-attente-stock" ) {
    echo "Etat coherent : commande marquee en attente, stock non decremente.\n";
} else {
    echo "INCOHERENCE : verifier l etat exact.\n";
}
'
Ce que l’interruption a révélé
Le premier passage de ce test a immédiatement révélé le défaut redouté : la commande restait enregistrée avec un statut « payée », alors que le stock n’avait jamais été décrémenté, créant une survente potentielle indétectable sans cette vérification explicite. Le correctif a consisté à introduire une transaction unique englobant la création de la commande et la décrémentation du stock, avec un statut intermédiaire explicite tant que la notification, moins critique, n’était pas encore envoyée.
| Point d’interruption | État observé avant correctif | État après correctif |
|---|---|---|
| Après création commande | Statut incohérent avec le stock | Statut « en attente », transaction non validée |
| Après décrémentation stock | Notification jamais renvoyée | File de reprise qui renvoie la notification manquante |
Distinguer l’interruption du processus d’une simple coupure réseau
Une coupure de connexion réseau entre le client et le serveur laisse généralement le worker terminer son traitement normalement, seule la réponse ne parvient jamais au client. L’interruption brutale du processus lui-même est un scénario distinct et souvent plus dangereux, car il arrête l’exécution à un point strictement imprévisible du point de vue du code, sans possibilité de rattrapage dans un bloc finally classique.
Un système qui survit à une coupure réseau n’a rien prouvé sur sa capacité à survivre à la mort brutale d’un de ses propres processus. Ce sont deux résiliences différentes, qui méritent deux tests différents.
En résumé
Interrompre volontairement un worker PHP-FPM en pleine requête, à un point précis et reproductible, révèle des incohérences que les tests menés jusqu’à leur terme ne détecteront jamais. Ce type de test demande un environnement dédié et un script de vérification d’état après coup, mais il transforme une hypothèse de résilience en un fait vérifié, avant qu’un incident réel ne le fasse à la place de l’équipe.