Neuf minutes. C’est le temps qu’une suite PHPUnit d’environ six cents tests met à s’exécuter dans une pipeline d’intégration continue, et c’est le chiffre qui a poussé une équipe à envisager Paratest pour répartir l’exécution sur plusieurs processus. Avant d’ajouter cette complexité, une question mérite d’être posée : est-ce que ces neuf minutes sont réparties équitablement entre six cents tests rapides, ou concentrées sur une poignée de tests lents qui plombent tout le reste ?
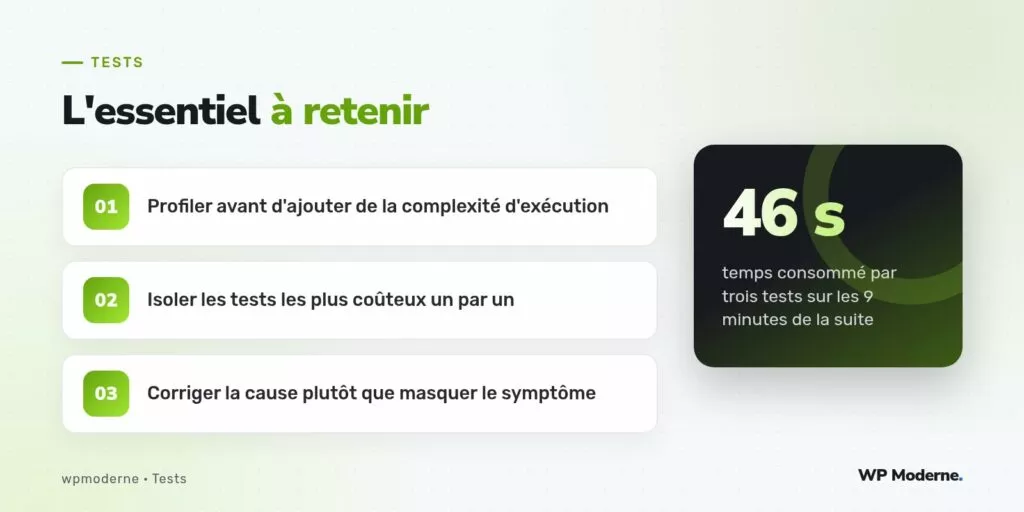
Dans le cas observé ici, trois tests représentaient à eux seuls quarante-six secondes, soit près de neuf pour cent du temps total. Paralléliser aurait divisé le temps global, mais aurait aussi figé une inefficacité qui pouvait être corrigée directement, sans complexité supplémentaire à maintenir.
Pourquoi paralléliser en premier réflexe est risqué
Ajouter des workers parallèles résout un symptôme sans jamais expliquer sa cause. Un test qui ouvre une connexion réseau non simulée, un test qui recrée une table entière de la base de données à chaque exécution, ou une fixture partagée reconstruite inutilement à chaque cas : ces problèmes restent présents après la parallélisation, simplement répartis sur plusieurs processus au lieu d’un seul. Pire, certains bugs de tests, comme un état partagé entre deux cas qui s’exécutaient auparavant l’un après l’autre, deviennent visibles seulement une fois parallélisés, sous forme d’échecs intermittents difficiles à reproduire.
Profiler avant d’agir permet de distinguer une suite uniformément lente, où la parallélisation a du sens, d’une suite ponctuée de quelques tests anormalement coûteux, où un correctif ciblé suffit.
Mesurer le temps réel test par test
PHPUnit propose nativement un rapport de temps d’exécution grâce à l’option --log-junit combinée à une lecture du fichier généré, ou plus directement via l’extension de rapport intégrée :
vendor/bin/phpunit --log-junit rapport.xml
Le fichier XML généré contient, pour chaque test, un attribut time exprimé en secondes. Un script court permet de trier ces temps et d’identifier immédiatement les tests les plus coûteux :
php -r '
$xml = simplexml_load_file("rapport.xml");
$temps = array();
foreach ($xml->xpath("//testcase") as $cas) {
    $temps[(string) $cas["name"]] = (float) $cas["time"];
}
arsort($temps);
foreach (array_slice($temps, 0, 10, true) as $nom => $duree) {
    echo round($duree, 2) . "s\t" . $nom . PHP_EOL;
}
'
Les causes les plus fréquentes de lenteur isolée
Une fois les tests les plus lents identifiés, l’inspection du code révèle généralement l’une de ces situations :
- Un appel à
sleep()ou à une temporisation figée, ajouté un jour pour contourner une instabilité et jamais retiré. - Une fixture recréée intégralement dans chaque méthode
setUp()alors qu’une factory partagée suffirait. - Un appel réseau réel vers une API externe, non simulé, dont la latence varie selon les conditions du moment.
- Une requête WP_Query sans limite explicite, qui parcourt un jeu de données de test surdimensionné.
Corriger la cause plutôt que la contourner
Dans le cas des trois tests responsables des quarante-six secondes, l’enquête a révélé un appel direct à une API de conversion de devises non simulée dans un test censé vérifier uniquement le calcul d’un total de commande. Le remplacement de cet appel par un simple mock a fait passer ce test de dix-huit secondes à moins d’une seconde, sans toucher à un seul autre fichier de la suite.
Un test lent n’est presque jamais lent « par nature ». Il est lent parce qu’il fait, en plus de ce qu’il prétend vérifier, quelque chose qu’il n’a pas à faire.
Quand la parallélisation redevient pertinente
Après correction des tests anormalement lents, il arrive que le temps total reste élevé simplement parce que le volume de tests a grandi avec le projet. Dans ce cas, la parallélisation retrouve tout son sens, mais elle s’applique alors à une suite assainie, où chaque worker traite des tests dont la durée est prévisible plutôt que polluée par quelques anomalies isolées.
Mettre en place un garde-fou durable
Pour éviter qu’un nouveau test anormalement lent ne passe inaperçu, un seuil peut être vérifié automatiquement à chaque exécution de la pipeline, en comparant le temps de chaque test à une limite fixée, par exemple deux secondes, et en faisant échouer la construction si ce seuil est dépassé sans justification documentée dans le code du test.
En résumé
Avant d’ajouter des workers parallèles à une suite de tests jugée lente, mesurer précisément où passe le temps évite d’investir dans une complexité d’exécution pour masquer un problème qui aurait pu se régler en quelques minutes. Le profilage n’est pas une étape optionnelle avant la parallélisation, c’est souvent l’étape qui la rend inutile.