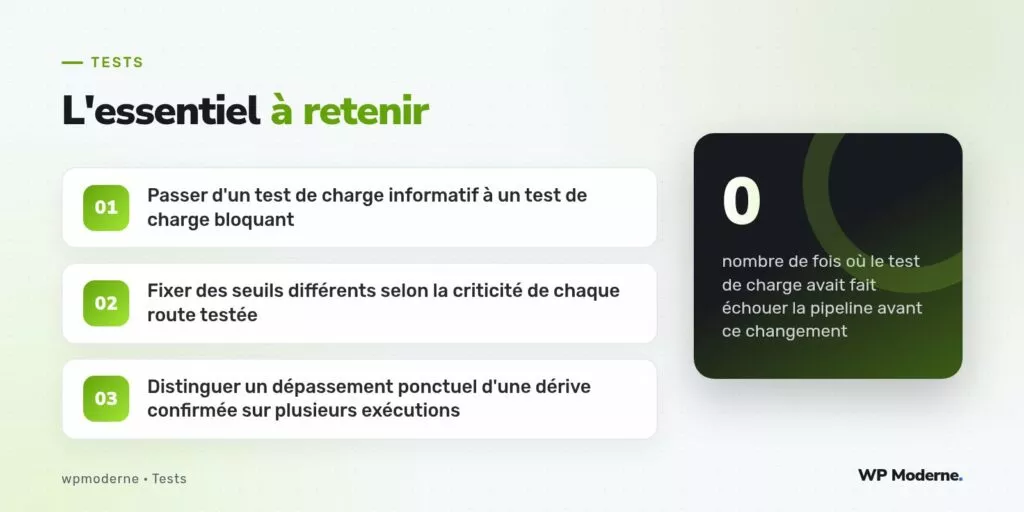
Zéro. C’est le nombre de fois où le test de charge exécuté chaque semaine sur la plateforme de réservation d’ateliers avait fait échouer la pipeline d’intégration continue depuis sa mise en place quatorze mois plus tôt, alors même que trois incidents de lenteur en production avaient été constatés sur cette même période. Le test tournait, produisait un rapport détaillé, personne ne le consultait systématiquement, et aucun seuil ne conditionnait le résultat de la pipeline à ce rapport.
Un test de charge purement informatif finit toujours par ce même sort : consulté quand tout va mal, ignoré le reste du temps. Le transformer en condition d’échec explicite change radicalement son utilité, à condition de choisir des seuils qui reflètent réellement ce que l’activité peut tolérer.
Pourquoi un rapport sans seuil ne protège personne
Un rapport de test de charge affiche des chiffres : temps de réponse moyen, temps de réponse au quatre-vingt-quinzième centile, taux d’erreur. Sans seuil défini à l’avance, interpréter ces chiffres devient une tâche subjective, réalisée différemment selon la personne qui consulte le rapport et selon son humeur du jour. Un seuil transforme cette interprétation en une décision automatique et reproductible.
Définir les seuils dans le script de test lui-même
Avec k6, les seuils se déclarent directement dans la configuration du scénario, sous la forme de conditions vérifiées automatiquement à la fin de l’exécution :
export const options = {
  scenarios: {
    reservation_atelier: {
      executor: 'ramping-vus',
      startVUs: 0,
      stages: [
        { duration: '2m', target: 50 },
        { duration: '5m', target: 50 },
        { duration: '2m', target: 0 },
      ],
    },
  },
  thresholds: {
    http_req_duration: ['p(95)<800'],
    http_req_failed: ['rate<0.01'],
  },
};
Si le temps de réponse au quatre-vingt-quinzième centile dépasse huit cents millisecondes, ou si le taux d’erreur dépasse un pour cent, k6 retourne un code de sortie non nul, ce qui suffit à faire échouer l’étape correspondante dans la pipeline.
Intégrer le résultat à la pipeline sans étape supplémentaire lourde
test-charge:
  script:
    - k6 run scenario-reservation.js
  allow_failure: false
Fixer des seuils différents selon la criticité de chaque route
Appliquer un seuil unique à l’ensemble des routes testées ignore une réalité simple : une route de consultation du catalogue d’ateliers peut tolérer un temps de réponse plus long qu’une route de confirmation de paiement, dont la lenteur affecte directement le taux de conversion. Les seuils se déclinent donc route par route :
| Route | Seuil de latence (p95) | Seuil de taux d’erreur |
|---|---|---|
| Consultation du catalogue | 1 500 ms | 2 % |
| Ajout d’un atelier au panier | 1 000 ms | 1 % |
| Confirmation de paiement | 800 ms | 0,5 % |
Distinguer un dépassement ponctuel d’une dérive confirmée
Un test de charge bloquant sans nuance risque de faire échouer la pipeline pour un dépassement isolé, par exemple si l’infrastructure de test partage temporairement ses ressources avec un autre traitement inhabituel. La règle adoptée exige deux exécutions consécutives au-dessus du seuil avant de bloquer réellement le déploiement, tout en conservant une alerte visible dès le premier dépassement :
- Premier dépassement : alerte envoyée à l’équipe, pipeline non bloquée, exécution du test répétée immédiatement.
- Second dépassement consécutif : pipeline bloquée, déploiement suspendu jusqu’à investigation.
- Historique conservé sur plusieurs semaines pour repérer une dérive progressive même sans dépassement franc du seuil.
Un seuil trop strict finit contourné à la première fausse alerte ; un seuil trop lâche finit ignoré comme le rapport qu’il remplace. Le bon seuil est celui que l’équipe accepte de respecter sans discuter à chaque fois.
En résumé
Un test de charge qui ne conditionne aucun résultat reste un exercice de mesure sans conséquence, redécouvert seulement après un incident. En fixant des seuils différenciés selon la criticité de chaque route et en exigeant une confirmation avant de bloquer réellement la pipeline, le test de charge retrouve son rôle initial : empêcher qu’une dégradation de performance n’atteigne la production plutôt que la constater après coup.