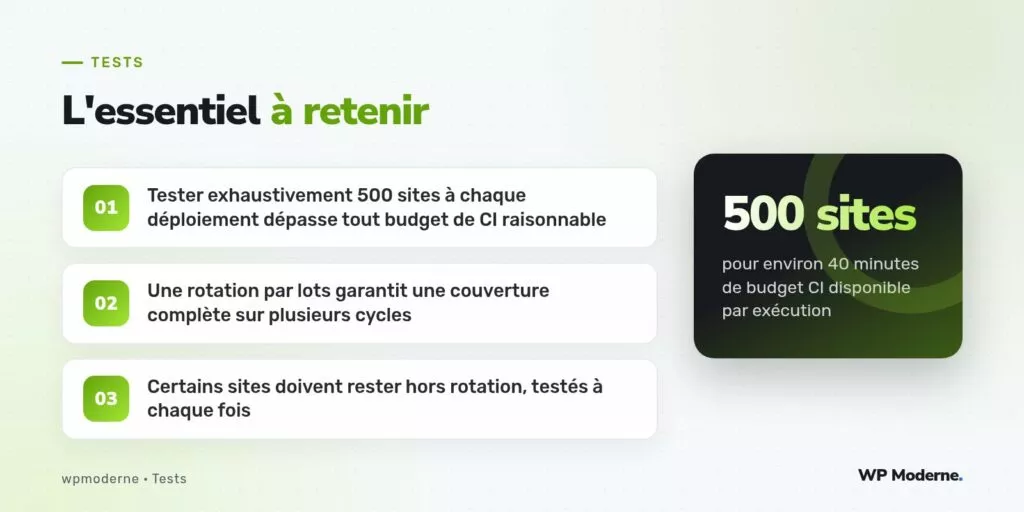
Cinq cents sites, chacun avec sa configuration de plugins, ses widgets, son thème enfant propre. Faire tourner la suite de tests d’intégration réseau sur l’intégralité du parc à chaque merge demanderait plusieurs heures — un budget que la CI de ce client, une fédération d’associations locales, ne peut simplement pas se permettre. Le choix n’était pas entre tester ou ne pas tester, mais entre tester exhaustivement de façon irréaliste, ou tester intelligemment un échantillon représentatif à chaque exécution.
Ce billet documente la stratégie d’échantillonnage mise en place, pas l’architecture de l’extension réseau elle-même (multisite, activation par site, gestion des quotas), qui relève d’un sujet distinct.
Pourquoi un échantillon aléatoire simple ne suffit pas
La première tentative — tirer cinquante sites au hasard à chaque exécution — semblait raisonnable, mais elle a rapidement laissé passer une régression touchant uniquement les sites configurés avec le mode multilingue activé, une configuration présente sur environ 8 % du parc seulement. Un tirage purement aléatoire a de bonnes chances de ne jamais inclure ce sous-ensemble sur plusieurs exécutions consécutives.
La stratégie de rotation par strates
Nous avons remplacé le tirage aléatoire par un échantillonnage stratifié : le parc est d’abord segmenté selon des critères de configuration significatifs (langue, thème actif, présence de tel ou tel plugin critique), puis un nombre fixe de sites est tiré dans chaque strate à chaque exécution, avec une rotation qui garantit qu’aucun site ne revient avant que tous les autres de sa strate n’aient été testés au moins une fois.
Représentation de la rotation
strates/
  multilingue/          (40 sites, 5 testés par cycle -> rotation sur 8 cycles)
  woocommerce-actif/     (120 sites, 10 testés par cycle -> rotation sur 12 cycles)
  theme-enfant-custom/   (75 sites, 8 testés par cycle -> rotation sur ~10 cycles)
  configuration-standard/ (265 sites, 15 testés par cycle -> rotation sur ~18 cycles)
Les sites qui restent en permanence hors rotation
- Le site pilote, utilisé pour valider chaque nouvelle fonctionnalité avant diffusion réseau, testé à chaque exécution sans exception
- Les trois sites ayant connu un incident de production dans les six derniers mois, gardés en surveillance renforcée temporaire
- Le site de plus fort trafic du réseau, dont une régression aurait l’impact le plus visible
Suivre la couverture réelle dans le temps
Un tableau de bord simple, généré à chaque exécution, consigne quels sites ont été testés et depuis combien de cycles chaque site n’a pas été couvert. Un site qui dépasse un seuil de vingt cycles sans passage déclenche une alerte manuelle, signe que la rotation est mal calibrée ou que le parc a grandi plus vite que prévu.
Ce que cette stratégie ne remplace pas
L’échantillonnage réduit le risque, il ne l’élimine pas. Une régression touchant un seul site très spécifique, hors de toute strate identifiée, peut toujours passer entre les mailles. C’est un compromis assumé, documenté auprès du client, entre budget de CI et couverture exhaustive.
Un échantillon bien pensé qui tourne à chaque exécution vaut mieux qu’une suite exhaustive qu’on finit par désactiver faute de temps.
En résumé
Tester un parc de 500 sites ne se résout pas par plus de puissance de calcul, mais par une meilleure question : quels sites, dans quel ordre, avec quelle garantie de retour. La stratification par configuration significative, plutôt qu’un tirage aléatoire naïf, a permis de détecter des régressions ciblées que l’échantillonnage précédent aurait manquées.