Un développeur qui découvre Search Console pour la première fois ouvre le rapport de couverture et trouve face à lui une liste de statuts au vocabulaire ambigu : « Détectée, actuellement non indexée », « Explorée, actuellement non indexée », « Dupliquée sans URL canonique sélectionnée par l’utilisateur ». Ces formulations ressemblent à des messages d’erreur, mais elles recouvrent des situations très différentes, dont certaines ne sont même pas des problèmes.
Cet article détaille la lecture technique de ces statuts. L’automatisation de leur suivi via l’API, elle, est traitée dans un article dédié à part.
Les statuts qui ne sont pas des erreurs
« Explorée, actuellement non indexée » signifie que Googlebot a bien récupéré la page, mais a choisi de ne pas l’ajouter à l’index. Ce n’est pas un problème technique : c’est un jugement de valeur de l’algorithme sur l’intérêt de la page par rapport au reste du corpus déjà indexé. Une page produit avec très peu de contenu unique, dupliquée en substance avec dix autres variantes de couleur, se retrouve typiquement dans ce statut.
« Détectée, actuellement non indexée » va plus loin : Google connaît l’existence de l’URL (via un lien ou le sitemap) mais ne l’a même pas encore explorée, souvent faute de budget de crawl suffisant alloué à ce site à ce moment-là.
Les statuts liés au canonical
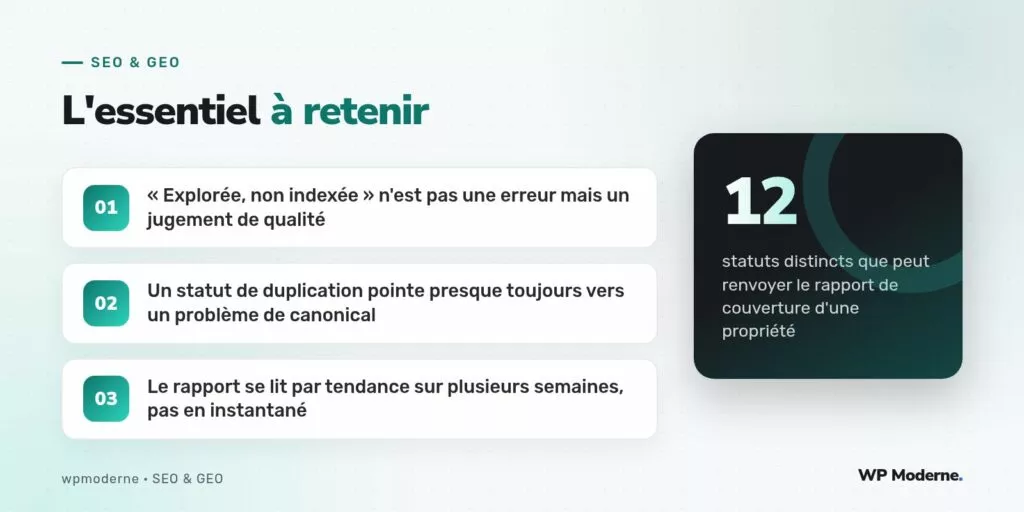
« Dupliquée, Google a choisi une URL canonique différente de celle de l’utilisateur » est le statut le plus fréquemment mal interprété par les développeurs WordPress. Il apparaît quand la balise rel="canonical" déclarée sur une page pointe vers une URL A, mais que Google, après analyse, a décidé de considérer une URL B comme canonique à sa place.
| Statut | Signification | Action recommandée |
|---|---|---|
| Dupliquée sans canonique sélectionnée | Aucune balise canonical déclarée, contenu proche d’une autre URL | Ajouter une balise canonical explicite |
| Dupliquée, Google a choisi une autre URL canonique | Le canonical déclaré est ignoré par l’algorithme | Vérifier la cohérence réelle du contenu entre les deux URL |
| Page alternative avec balise canonique correcte | Comportement normal et voulu | Aucune action |
Sur un site WordPress, ce statut apparaît souvent sur les pages de pagination d’archive (/categorie/actu/page/2/) mal configurées, ou sur des versions avec et sans paramètre de tri (?orderby=date) qui exposent un contenu quasi identique sans que le canonical ne soit correctement propagé par le thème vers la version sans paramètre.
Les erreurs de serveur et de robots.txt
« Bloquée par robots.txt » et « Erreur de serveur (5xx) » sont, elles, de vraies erreurs à corriger rapidement. Une confusion fréquente sur WordPress : une règle Disallow: /wp-admin/ mal placée dans un fichier robots.txt personnalisé peut, par erreur de chemin, bloquer également un répertoire de contenu si le développeur a copié-collé une règle générique sans l’adapter à l’arborescence réelle du site.
wp eval 'echo file_get_contents( ABSPATH . "robots.txt" );'
curl -s https://exemple.fr/robots.txt
Lire le rapport dans le temps, pas en instantané
Le nombre d’URL sur un statut donné évolue par vagues liées aux passages de Googlebot, avec un décalage qui peut atteindre plusieurs semaines entre une correction technique et sa prise en compte visible dans le rapport. Un développeur qui corrige un problème de canonical un lundi et s’attend à voir le rapport se vider le mardi se trompe systématiquement de fenêtre de lecture.
Je recommande toujours de faire une capture du rapport avant intervention, puis de comparer à quinze jours, puis à un mois : la tendance compte plus que le chiffre du jour.
En résumé
La majorité des statuts du rapport de couverture ne sont pas des pannes à corriger dans l’urgence, mais des indications de la façon dont Google hiérarchise votre contenu. Seuls les statuts d’erreur serveur, de blocage robots.txt et certains cas de duplication non résolue appellent une intervention technique immédiate ; le reste se pilote sur la durée, en observant la tendance plutôt que l’instantané.