Un site d’actualités régionales cumulait huit mille articles publiés depuis 2011, avec un maillage interne quasiment inexistant : les auteurs successifs avaient rarement pris le temps de lier leurs articles entre eux, et les quelques extensions de maillage automatique testées par le client plafonnaient toutes autour de deux mille articles avant de ralentir l’administration jusqu’à la rendre inutilisable.
La demande du client était claire : proposer des liens internes pertinents entre articles anciens et récents, sans dépendre du bloc Requête natif qui aurait nécessité de retravailler chaque gabarit un par un pour un résultat encore aléatoire sur un corpus aussi hétérogène.
Le constat de départ
Un export de la base a permis de mesurer l’ampleur du problème avant d’écrire la moindre ligne de script :
wp db query "SELECT COUNT(*) AS total,
  SUM( (LENGTH(post_content) - LENGTH(REPLACE(post_content, '<a ', ''))) / 3 ) AS liens
  FROM wp_posts WHERE post_type='post' AND post_status='publish'"
Résultat : 8 012 articles publiés pour à peine 3 400 liens internes au total, soit une moyenne de 0,42 lien par article, très en dessous des trois à cinq liens internes recommandés par article de ce volume.
Le principe du script : un score de pertinence lexicale
Plutôt qu’un rapprochement par catégorie seule (trop grossier sur un corpus aussi ancien où les catégories avaient changé plusieurs fois de structure), le script calcule un score de similarité basé sur les mots-clés significatifs extraits du titre et des cent premiers mots de chaque article, après retrait des mots vides français.
function extraire_mots_cles( string $texte ): array {
    $mots_vides = array( 'les', 'des', 'une', 'dans', 'pour', 'avec', 'sur', 'est' );
    $mots = preg_split( '/[\s,;.!?]+/', mb_strtolower( $texte ) );
    $mots = array_filter( $mots, fn( $m ) => mb_strlen( $m ) > 3 && ! in_array( $m, $mots_vides, true ) );
    return array_count_values( $mots );
}

function score_similarite( array $mots_a, array $mots_b ): float {
    $communs = array_intersect_key( $mots_a, $mots_b );
    return array_sum( $communs );
}
Le traitement par lots pour tenir en mémoire
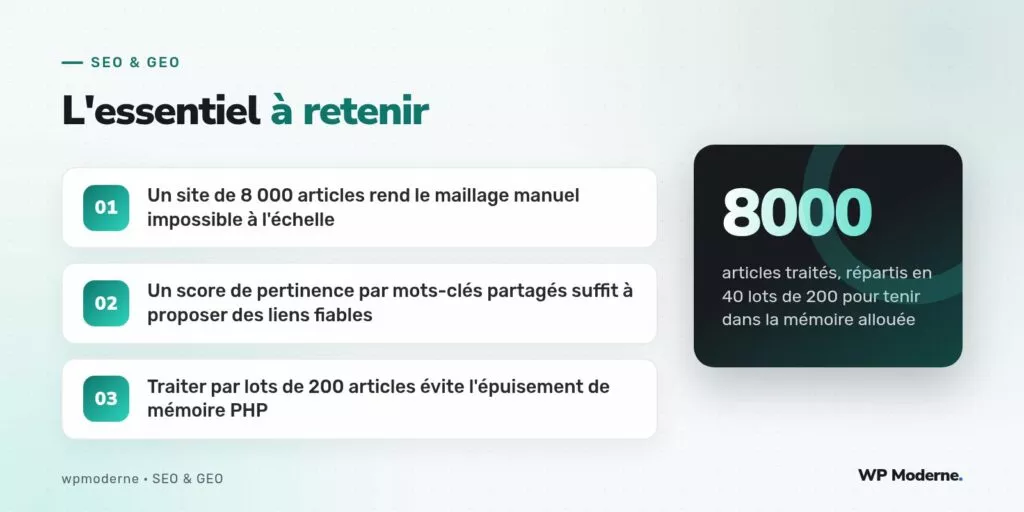
Charger huit mille articles et leur contenu en mémoire simultanément dans un script PHP exécuté via WP-CLI a d’abord provoqué un épuisement de mémoire (Allowed memory size exhausted) même avec une limite relevée à 512 Mo. La solution retenue : traiter les articles par lots de 200, avec un index de mots-clés déjà calculé et stocké en champ personnalisé, pour éviter de recalculer l’extraction à chaque comparaison croisée.
class Maillage_Reprise_Command {
    public function calculer_index( $args ) {
        $lot = (int) ( $args[0] ?? 0 );
        $articles = get_posts( array(
            'post_type'      => 'post',
            'posts_per_page' => 200,
            'offset'         => $lot * 200,
            'orderby'        => 'ID',
        ) );

        foreach ( $articles as $article ) {
            $mots = extraire_mots_cles( $article->post_title . ' ' . wp_trim_words( $article->post_content, 100 ) );
            update_post_meta( $article->ID, '_index_mots_cles', $mots );
        }
        WP_CLI::success( "Lot $lot traité : " . count( $articles ) . " articles" );
    }
}
WP_CLI::add_command( 'maillage index-lot', array( 'Maillage_Reprise_Command', 'calculer_index' ) );
Exécuté en quarante passages successifs pilotés par un script bash, avec une pause d’une seconde entre chaque lot pour ne pas saturer le serveur de production :
for i in $(seq 0 39); do
  wp maillage index-lot "$i"
  sleep 1
done
La validation humaine reste indispensable
Le score de similarité lexicale propose de bons candidats neuf fois sur dix, mais il ne comprend pas le sens : sur ce corpus, il a par exemple rapproché un article sur un « accident de la route » avec un fait divers sans rapport simplement parce que les deux textes partageaient un nombre inhabituel de mots-clés liés à un même nom de commune. Toutes les suggestions ont été validées manuellement par lot de vingt avant insertion effective du lien.
Le résultat
Sur les huit mille articles, 21 400 suggestions de liens ont été générées, dont 14 800 validées et insérées après relecture éditoriale répartie sur six semaines. Le nombre moyen de liens internes par article est passé de 0,42 à 2,1, avec un effet mesurable sur le temps de session moyen constaté trois mois après la campagne.
En résumé
Aucune extension du marché n’était dimensionnée pour un corpus de huit mille articles accumulés sans discipline éditoriale pendant douze ans. Un script maison basé sur un score lexical simple, exécuté par lots pour tenir dans la mémoire disponible, a permis de reprendre ce maillage sans réécrire un seul article, à condition de garder une validation humaine sur chaque suggestion avant publication.