Une confusion revient sans cesse chez les développeurs qui découvrent le sujet : croire que « noindex » et « nofollow » sont deux synonymes d’un même besoin, celui de « cacher une page ». Ce sont en réalité deux instructions indépendantes, qui peuvent se combiner de quatre façons, et chacune a un effet précis sur la façon dont Google traite une page et les liens qu’elle contient.
Sur un site WordPress un peu structuré (archives d’auteur, pages de résultats de recherche, pages de connexion personnalisées, contenus sous embargo), la question se pose vite : quelle balise poser où ? Ce billet détaille les quatre combinaisons et les cas où chacune a du sens, sans passer par une extension SEO complète.
La balise meta robots et sa syntaxe exacte
La balise s’écrit dans le <head> du document :
<meta name="robots" content="noindex, follow" />Le contenu de l’attribut content accepte une liste de directives séparées par des virgules. Les deux qui nous intéressent ici sont index/noindex (la page doit-elle apparaître dans les résultats de recherche) et follow/nofollow (Google doit-il suivre les liens sortants de cette page pour les explorer et leur transmettre du crédit). Par défaut, en l’absence de toute balise, une page est considérée comme index, follow.
Les quatre combinaisons et leurs usages réels
Voici comment choisir concrètement, type de contenu par type de contenu :
- index, follow (défaut) : toutes les pages de contenu éditorial destinées au public — articles, pages de service, catégories principales.
- noindex, follow : pages utiles à l’utilisateur mais sans valeur de recherche propre — pages de résultats de recherche interne, pages de remerciement après formulaire, pagination profonde d’archive. Google n’indexe pas la page, mais continue d’explorer les liens qu’elle contient, ce qui préserve la découverte du reste du site.
- noindex, nofollow : à réserver aux pages réellement privées ou sans intérêt de maillage — page de connexion personnalisée, panier, zones d’administration front-end. Attention : cette combinaison coupe la transmission de PageRank via cette page, ce qui peut isoler des contenus si elle est mal utilisée sur une page centrale.
- index, nofollow : rare et souvent contre-productif. Utile uniquement si une page doit être indexée mais que ses liens sortants ne doivent transmettre aucun crédit (page listant des partenaires payants, par exemple), un cas de figure marginal sur la majorité des sites.
Implémenter la logique sans extension SEO
Avant l’arrivée du filtre wp_robots dans le cœur de WordPress, la façon la plus fiable de poser cette balise reste d’accrocher une fonction tôt sur wp_head, avant les autres sorties de balises meta :
add_action( 'wp_head', function () {
    if ( is_search() || is_404() ) {
        echo '<meta name="robots" content="noindex, follow" />' . "\n";
        return;
    }

    if ( is_page( 'connexion-espace-client' ) ) {
        echo '<meta name="robots" content="noindex, nofollow" />' . "\n";
    }
}, 1 );
Le priorité 1 permet de s’assurer que cette balise apparaît avant d’autres sorties, ce qui facilite le débogage visuel dans le code source. Il faut également vérifier qu’aucune extension tierce ne pose déjà une balise robots concurrente : deux balises meta robots contradictoires sur la même page sont possibles techniquement, et Google applique alors la plus restrictive, ce qui peut surprendre.
Les pièges les plus fréquents
Le premier piège consiste à appliquer noindex, nofollow par réflexe à toutes les pages qu’on juge « secondaires », y compris des pages de catégorie qui reçoivent des liens internes utiles. Le second est d’oublier qu’une page en noindex reste techniquement accessible et explorable si elle n’est pas bloquée dans le robots.txt : Google visite la page, lit la balise, puis la retire de l’index à la prochaine exploration, ce qui peut prendre plusieurs jours.
Sur les projets où je pose ce genre de règle, je documente toujours la liste des templates concernés dans un commentaire au-dessus de la fonction : six mois plus tard, personne ne se souvient pourquoi telle page est en noindex.
Notion à ne pas confondre : robots.txt versus meta robots
Une page bloquée dans le robots.txt via Disallow n’est jamais explorée, donc sa balise meta robots n’est jamais lue : Google peut malgré tout l’indexer sans description si elle reçoit des liens externes, un comportement souvent mal compris. Pour retirer une page de l’index de façon fiable, il faut la laisser explorable et poser la balise noindex, pas la bloquer dans le robots.txt.
Notre verdict
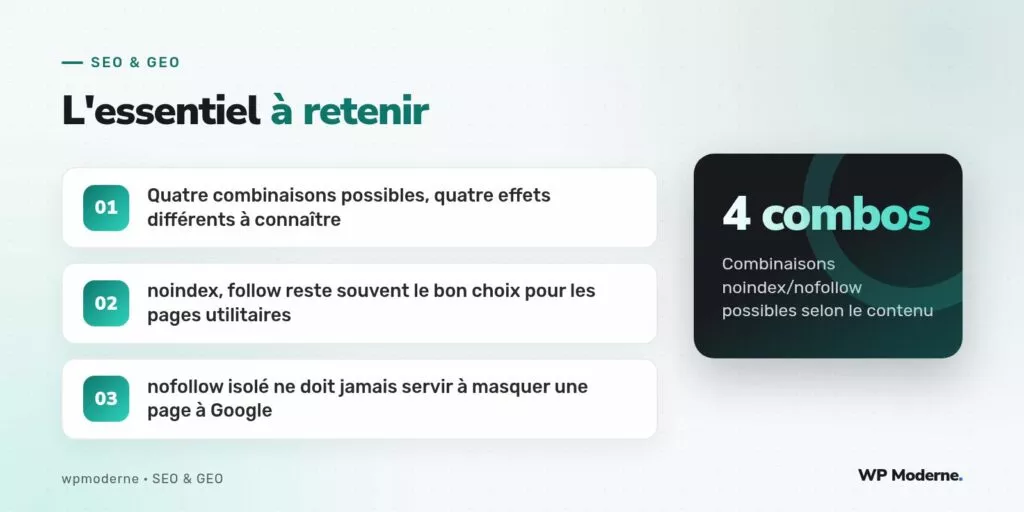
Retenez une règle simple : noindex, follow est le choix par défaut pour tout ce qui est utilitaire mais lié au reste du site, et nofollow isolé ne doit jamais être une méthode de dissimulation. Bien posée, cette logique se code en une trentaine de lignes et rend une extension SEO complète superflue pour ce seul besoin.