Que se passe-t-il, concrètement, dans les journaux d’accès d’un site dans les jours qui suivent une montée de version majeure du cœur ? La réponse dépend rarement d’une fonctionnalité phare annoncée en fanfare : elle tient presque toujours à des détails de rendu HTML modifiés en profondeur, sans lien apparent avec le référencement, qui changent pourtant la façon dont un robot perçoit et explore les pages.
À l’approche d’une montée de version majeure, l’équipe technique se concentre naturellement sur la compatibilité des extensions et du thème. Le comportement des robots d’exploration mérite pourtant sa propre liste de vérifications, distincte de la compatibilité fonctionnelle classique, tant les deux sujets répondent à des logiques différentes.
Pourquoi une montée de version peut modifier le comportement des robots
Une nouvelle version majeure du cœur touche souvent, en marge de ses fonctionnalités phares, des détails moins visibles : l’ordre des balises générées dans le <head>, la structure exacte du flux RSS natif, ou le format des liens de pagination générés automatiquement. Aucun de ces changements n’est présenté comme un sujet SEO dans les notes de version, et c’est précisément ce qui les rend faciles à manquer lors d’une préparation classique de mise à jour.
- Modification de l’ordre ou du contenu des balises
metagénérées nativement. - Changement dans la structure du flux RSS ou des liens de pagination automatiques.
- Évolution du comportement par défaut de fonctions de requête utilisées par des thèmes ou extensions maison.
Poste par poste : ce qu’il faut revérifier après la mise à jour
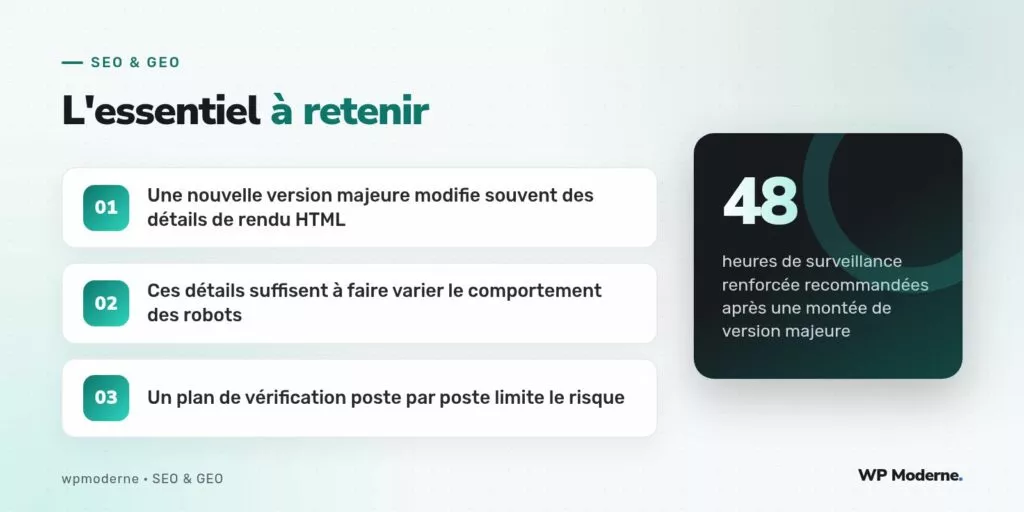
Plutôt que de chercher à deviner à l’avance chaque changement, la méthode la plus fiable consiste à établir un plan de vérification poste par poste, applicable après chaque montée de version majeure, indépendamment des nouveautés annoncées cette année-là.
- Comparer le code source généré d’une page type avant et après la mise à jour, balise par balise dans le
<head>. - Vérifier que le sitemap natif conserve la même structure et le même nombre d’entrées.
- Contrôler que le flux RSS principal reste valide via un validateur de flux standard.
- Surveiller le volume de requêtes des principaux robots dans les journaux serveur sur les quarante-huit heures suivant la bascule.
- Vérifier qu’aucune page ne renvoie de code d’erreur inattendu sur les URLs les plus explorées habituellement.
Un exemple de dérive silencieuse déjà observé
Sur un projet suivi après une précédente montée de version majeure, la structure des liens de pagination générés par une fonction de requête interne avait légèrement changé, sans erreur ni avertissement visible. Le volume de crawl sur les pages profondes de catégorie a chuté de près d’un tiers dans les deux semaines suivantes, un effet qui n’est apparu clairement qu’en comparant les journaux serveur avant et après la mise à jour.
Mettre en place une fenêtre de surveillance renforcée
Une fenêtre de quarante-huit heures de surveillance renforcée des journaux serveur, centrée sur les principaux robots d’exploration, permet de détecter rapidement une variation anormale de fréquence de crawl. Passé ce délai, un comparatif hebdomadaire suffit généralement à confirmer que le comportement des robots s’est stabilisé au niveau attendu.
awk '{print $4}' access.log \
  | grep "Googlebot" \
  | cut -d: -f2-3 \
  | sort | uniq -c
Cette commande répartit les passages de Googlebot par tranche horaire, un moyen simple de visualiser un éventuel changement de rythme d’exploration après la bascule vers une nouvelle version majeure.
Une note de version qui ne mentionne aucun changement SEO ne garantit jamais l’absence d’effet sur le crawl : elle garantit seulement l’absence d’intention de le modifier.
En résumé
Anticiper l’effet d’une montée de version majeure sur la fréquence de crawl ne demande pas de deviner à l’avance chaque nouveauté technique : cela demande un plan de vérification structuré, appliqué systématiquement après chaque bascule, et une fenêtre de surveillance resserrée des journaux serveur dans les jours qui suivent.