Un client nous signale que son extension de limitation de tentatives de connexion, configurée pour bloquer une IP après cinq échecs en dix minutes, semble totalement inefficace : les journaux du serveur montrent des centaines de tentatives de connexion échouées sur le compte admin, réparties sur toute une nuit, sans qu’aucun blocage ne se déclenche. En analysant les adresses IP sources dans les journaux d’accès, plus de 400 adresses distinctes apparaissent, chacune n’ayant tenté qu’une ou deux connexions avant de disparaître des journaux.
C’est une attaque par force brute distribuée, orchestrée depuis un réseau de machines compromises (un botnet) ou via un service de proxy rotatif loué à la minute. Chaque IP individuelle reste largement sous le seuil de blocage configuré, alors que l’ensemble de l’attaque représente plusieurs centaines de tentatives contre un seul et même compte cible. Le problème vient du niveau auquel le compteur est appliqué : par IP, alors que la cible réelle de l’attaque est un compte, pas une origine réseau.
Changer d’angle : compter par compte visé, pas par origine
La bascule conceptuelle nécessaire est simple à énoncer : au lieu de se demander « cette IP a-t-elle trop échoué récemment ? », la question pertinente devient « ce compte a-t-il subi trop de tentatives récentes, peu importe d’où elles viennent ? ». Cette approche protège directement la ressource que l’attaquant cherche à compromettre, indépendamment de sa capacité à faire tourner ses tentatives sur un grand nombre d’adresses IP différentes.
Le risque symétrique de cette approche doit être anticipé dès la conception : un attaquant qui connaît ce mécanisme pourrait tenter de faire bloquer volontairement le compte d’un administrateur légitime en multipliant les échecs sur son identifiant, un déni de service ciblé sur les comptes plutôt qu’une prise de contrôle. La recette ci-dessous combine donc un ralentissement progressif plutôt qu’un blocage total, pour limiter ce risque.
La recette : un compteur par compte dans le cache d’objet
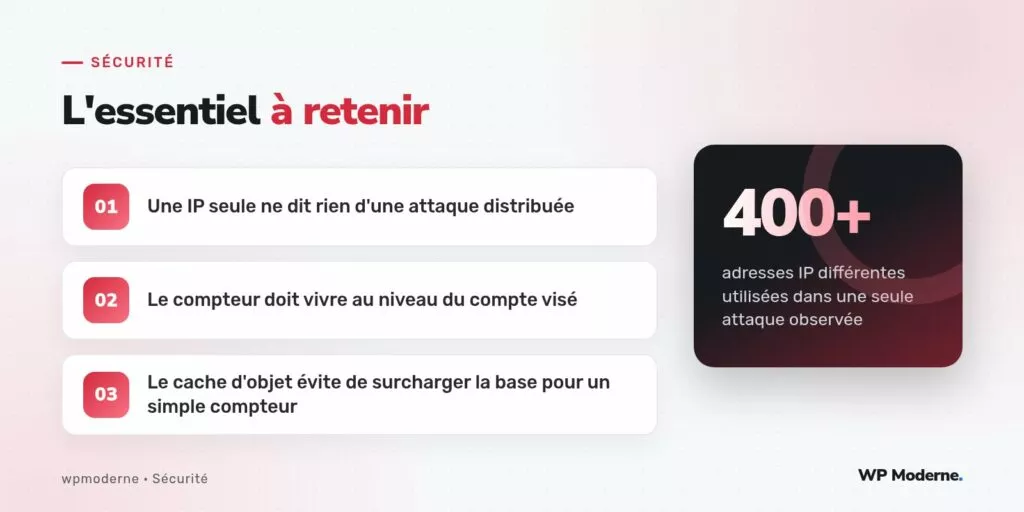
Utiliser le cache d’objet de WordPress (wp_cache_get() / wp_cache_set()) plutôt qu’une option en base de données évite d’alourdir wp_options avec des écritures fréquentes et de courte durée de vie ; sur un site disposant d’un cache d’objet persistant (Redis ou Memcached), ces compteurs vivent naturellement en mémoire, rapides à lire et à incrémenter :
add_filter( 'authenticate', 'moncpt_verifier_compteur_avant_connexion', 21, 3 );
add_action( 'wp_login_failed', 'moncpt_incrementer_compteur_echec', 10, 2 );
add_action( 'wp_login', 'moncpt_reinitialiser_compteur_echec', 10, 2 );

function moncpt_cle_compteur( $identifiant ) {
    return 'echecs_connexion_' . md5( strtolower( $identifiant ) );
}

function moncpt_verifier_compteur_avant_connexion( $user, $username, $password ) {
    if ( empty( $username ) ) {
        return $user;
    }

    $cle     = moncpt_cle_compteur( $username );
    $echecs  = (int) wp_cache_get( $cle, 'moncpt_securite' );

    if ( $echecs >= 10 ) {
        return new WP_Error(
            'trop_de_tentatives',
            __( 'Trop de tentatives de connexion pour ce compte. Réessayez plus tard ou réinitialisez votre mot de passe.', 'moncpt' )
        );
    }

    // Ralentissement progressif au-delà de trois échecs, avant le blocage complet.
    if ( $echecs >= 3 ) {
        usleep( $echecs * 300000 ); // jusqu'à 3 secondes de délai supplémentaire
    }

    return $user;
}

function moncpt_incrementer_compteur_echec( $username ) {
    $cle    = moncpt_cle_compteur( $username );
    $echecs = (int) wp_cache_get( $cle, 'moncpt_securite' );

    wp_cache_set( $cle, $echecs + 1, 'moncpt_securite', 15 * MINUTE_IN_SECONDS );
}

function moncpt_reinitialiser_compteur_echec( $username, $user ) {
    wp_cache_delete( moncpt_cle_compteur( $username ), 'moncpt_securite' );
}
Le hook authenticate, utilisé avec une priorité de 21 (donc après la vérification native du mot de passe par WordPress qui s’exécute par défaut à la priorité 20), permet d’intercepter la tentative avant qu’elle ne soit pleinement traitée, sans dupliquer la logique de vérification du mot de passe elle-même. Le compteur expire naturellement après quinze minutes d’inactivité sur ce compte, évitant un blocage permanent en cas d’attaque ponctuelle qui cesse.
Pourquoi le cache d’objet plutôt qu’une option ou une table dédiée
Sur un site sans cache d’objet persistant configuré, wp_cache_get() et wp_cache_set() continuent de fonctionner grâce au cache d’objet non persistant intégré à WordPress, mais celui-ci ne survit qu’à la durée d’une seule requête PHP — inutile pour un compteur censé durer plusieurs minutes. Sur ce type d’hébergement, une table dédiée ou l’API Transients (set_transient() / get_transient(), qui utilise wp_options en l’absence de cache persistant) reste la solution de repli, avec un coût en écritures base de données plus élevé mais un fonctionnement garanti dans tous les environnements :
// Version de repli avec l'API Transients, sans dépendance à un cache persistant
$echecs = (int) get_transient( moncpt_cle_compteur( $username ) );
set_transient( moncpt_cle_compteur( $username ), $echecs + 1, 15 * MINUTE_IN_SECONDS );
Le choix entre les deux dépend directement de l’infrastructure disponible : vérifier la présence d’un cache d’objet persistant avec wp_using_ext_object_cache() permet d’adapter automatiquement la stratégie sans configuration manuelle.
Combiner avec un blocage par IP, sans le remplacer
Cette approche par compte ne rend pas obsolète un blocage complémentaire par IP pour les cas de force brute non distribuée, plus simples et toujours fréquents sur des sites moins ciblés. Les deux mécanismes fonctionnent en parallèle sans se contredire : l’un protège contre l’acharnement sur une origine unique, l’autre contre la dispersion délibérée d’une attaque coordonnée.
Sur ce site client, la combinaison des deux compteurs a fait chuter le taux de réussite apparent de l’attaque distribuée à zéro dès la nuit suivante, sans qu’aucun visiteur légitime ne se soit plaint d’un blocage abusif durant le mois de suivi.
En résumé
Ce sujet ne couvre pas le force brute générique par IP, déjà traité par ailleurs avec ses propres mécanismes de blocage. Il rappelle un principe plus large de défense adaptative : la contre-mesure doit correspondre à l’angle réel de l’attaque, et une attaque distribuée nécessite de déplacer le niveau de comptage vers la ressource ciblée plutôt que vers l’origine, par nature trop mouvante pour être fiable.



