L’audit devait être une formalité. Un client nous confie la vérification de sécurité d’un site vitrine avant une refonte, sans alerte particulière, juste par prudence avant de rouvrir les accès à une nouvelle agence. Le genre de mission qu’on boucle en une demi-journée. Nous lançons notre liste habituelle de vérifications, dont un scan de recherche de fichiers sensibles exposés à la racine publique. Le résultat tombe en quelques secondes : un fichier backup-2020-01-15.sql de 40 Mo, directement accessible via une URL en https://exemple.fr/backup-2020-01-15.sql, sans aucune authentification.
Le fichier contenait l’intégralité de la base de données : table wp_users avec les hachages de mots de passe, table wp_options avec des clés d’API tierces stockées en clair par une extension de paiement, et les commentaires clients avec adresses e-mail. Six mois s’étaient écoulés depuis la dernière modification du fichier, d’après les métadonnées serveur. Personne ne l’avait remarqué, ni le client, ni l’hébergeur, ni Google — par chance, le fichier n’était pas indexé, faute de lien pointant vers lui.
Comment un tel fichier atterrit dans le webroot
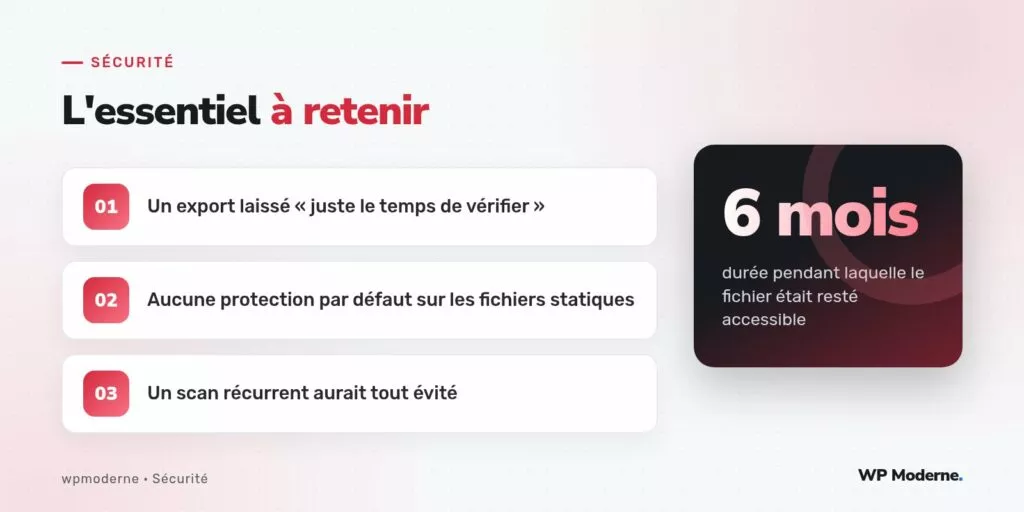
Ce scénario revient plus souvent qu’on ne le pense, et presque toujours pour la même raison : un développeur ou un prestataire génère une sauvegarde manuelle avant une migration, un test ou une intervention risquée, et la place dans un dossier accessible parce que c’est le chemin le plus rapide pour la récupérer ensuite (par exemple via un simple lien direct, plutôt que par FTP ou SSH). L’intention est presque toujours temporaire : « je la supprimerai après ». Sauf que l’urgence suivante arrive, et personne n’y repense.
On retrouve ce type de fichier dans des emplacements très variables selon les habitudes de chacun :
- À la racine du site, à côté de
wp-config.php. - Dans
wp-content/uploads, parce que le dossier est accessible en écriture par PHP et donc pratique pour un script d’export. - Dans un dossier nommé
backup,old,saveoutmpcréé pour l’occasion, sans.htaccessni règle de blocage. - Généré automatiquement par une extension de sauvegarde mal configurée qui écrit ses archives dans un chemin public plutôt que dans un stockage externe.
Une recherche systématique plutôt qu’un coup de chance
Ce cas nous a poussés à formaliser un scan que nous lançons désormais sur chaque audit, avant même de regarder le code. L’idée : plutôt que de chercher un fichier précis, on liste toutes les extensions et motifs de nommage qui trahissent un export de sauvegarde, et on vérifie leur présence à la racine et dans les dossiers publics courants.
#!/usr/bin/env bash
# Recherche de fichiers de sauvegarde exposés dans le webroot
WEBROOT="/var/www/exemple.fr"

find "$WEBROOT" -maxdepth 3 -type f \
  \( -iname "*.sql" -o -iname "*.sql.gz" -o -iname "*.sql.zip" \
     -o -iname "*backup*" -o -iname "*dump*" -o -iname "*.tar.gz" \
     -o -iname "*.bak" -o -iname "wp-config.php.*" \) \
  -printf "%TY-%Tm-%Td  %10s  %p\n" \
  | sort
La commande liste la date de dernière modification, la taille et le chemin de chaque fichier suspect. Sur un site propre, elle ne renvoie rien. Sur celui de ce client, elle a immédiatement isolé le fichier incriminé, avec sa date de modification qui a permis de dater précisément l’incident et de retrouver le prestataire responsable dans les échanges d’e-mails de l’époque.
Pour vérifier l’accessibilité réelle depuis l’extérieur (et pas seulement la présence sur le disque), on complète par une requête HTTP directe sur chaque chemin trouvé, avec l’option -o /dev/null -s -w de curl pour ne récupérer que le code de statut :
curl -o /dev/null -s -w "%{http_code}\n" \
  "https://exemple.fr/backup-2020-01-15.sql"
# 200 = catastrophe, 403/404 = protégé ou absent
Corriger dans l’urgence, puis dans la durée
Une fois le fichier trouvé, la première action est de le supprimer et de considérer comme compromis tout ce qu’il contenait : rotation immédiate des clés d’API tierces retrouvées en clair, forçage de la réinitialisation de mot de passe pour les comptes administrateurs, et vérification des journaux d’accès du serveur pour voir si le fichier a réellement été téléchargé par un tiers avant la découverte (une entrée GET /backup-2020-01-15.sql avec un code 200 dans les logs Apache ou Nginx est le signal à chercher).
Dans la durée, deux réflexes évitent la récidive :
- Bloquer par configuration serveur l’accès public à toute extension sensible, indépendamment de ce qui existe aujourd’hui sur le disque :
# Extrait de configuration Nginx
location ~* \.(sql|sql\.gz|bak|backup|tar\.gz)$ {
    deny all;
    return 404;
}- Interdire par convention d’équipe toute sauvegarde manuelle dans un dossier servi publiquement, en imposant un chemin hors webroot (par exemple
/home/backups/) pour tout export, même temporaire.
Sur nos audits, cette recherche de fichiers de sauvegarde exposés est devenue une étape systématique, au même titre que la vérification des permissions : elle prend trente secondes et a déjà évité deux fuites de données avant publication.
Pour aller plus loin
Ce cas ne concerne pas les sauvegardes automatisées gérées par une extension dédiée et stockées hors du webroot, qui suivent des règles de rétention et de chiffrement différentes — un sujet traité par ailleurs. Il s’agit ici spécifiquement du réflexe humain de « la copie qu’on laisse traîner », qui reste, des années après cette mission, l’une des découvertes les plus fréquentes de nos audits de sécurité sur des sites vitrine gérés en interne par de petites équipes.