« Si l’objet cache persistant devient indisponible, WordPress doit continuer de fonctionner en s’appuyant sur le cache non persistant de la requête en cours. » Cette phrase, qui résume l’esprit de l’API Object Cache documentée sur developer.wordpress.org, a pris tout son sens le jour où le serveur Redis d’un syndicat professionnel a cessé de répondre en pleine campagne annuelle d’adhésions.
Le site, qui traite plusieurs centaines de renouvellements d’adhésion sur une période resserrée, s’appuyait depuis des mois sur Redis comme objet cache persistant pour absorber la charge des pages membres. Sa panne aurait pu être catastrophique si aucun mécanisme de repli n’avait été prévu.
Ce qui s’est réellement passé côté serveur
L’incident a été déclenché par une saturation mémoire du conteneur Redis, configuré avec une politique maxmemory-policy trop stricte pour le volume de données mis en cache pendant la campagne. Le service Redis a fini par refuser toute nouvelle connexion, renvoyant des erreurs de type Connection refused à chaque tentative d’écriture ou de lecture depuis le plugin Redis Object Cache.
Sur un site sans mécanisme de repli correctement configuré, ce type de panne se traduit généralement par des erreurs fatales PHP ou par un site entièrement figé, le code s’appuyant sur le cache pour fonctionner sans jamais avoir prévu son absence.
Le mécanisme de repli qui a limité la casse
Le plugin Redis Object Cache installé sur ce site intègre une détection de connexion : lorsqu’il ne parvient plus à joindre le serveur Redis, il bascule automatiquement vers le comportement par défaut de WordPress, à savoir un cache non persistant limité à la durée de la requête en cours, complété par les transients stockés en base de données via set_transient et get_transient.
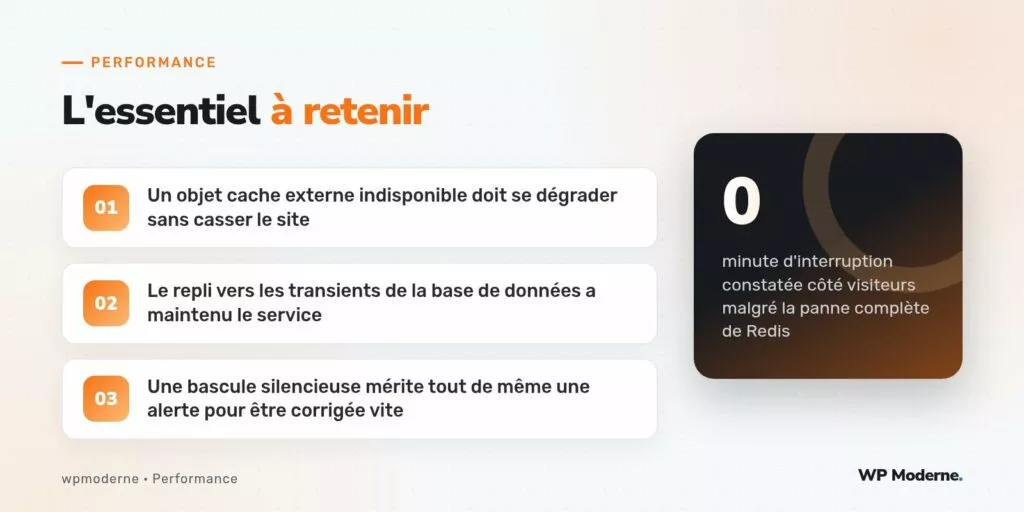
Concrètement, chaque page a continué de se générer normalement, simplement plus lentement qu’avec Redis actif, la base de données MySQL absorbant seule la charge que Redis assumait auparavant. Le site est resté accessible, avec un temps de génération dégradé mais acceptable, le temps que l’équipe technique redémarre le service.
Vérifier qu’un site bascule correctement
Ce comportement de repli n’est pas garanti par défaut sur toutes les configurations. Il dépend directement du code du object-cache.php déposé dans le dossier wp-content, et du soin apporté par son auteur à gérer les exceptions de connexion. Un test simple consiste à couper artificiellement l’accès réseau vers Redis sur un environnement de préproduction et à observer le comportement du site :
- Le site continue-t-il de répondre, même dégradé, ou affiche-t-il une erreur fatale ?
- La fonction
wp_using_ext_object_cache()renvoie-t-elle correctement l’état réel de la connexion ? - Une alerte de supervision se déclenche-t-elle pour signaler la bascule aux équipes techniques ?
Pourquoi la vitesse de détection compte autant que le repli
Un repli silencieux, sans notification, peut masquer un problème de fond pendant des jours : le site fonctionne, personne ne s’inquiète, mais la base de données encaisse une charge qu’elle n’est pas dimensionnée pour supporter durablement. La bonne pratique consiste à coupler le repli technique à une alerte de supervision, par exemple via un contrôle programmé qui interroge périodiquement l’état de la connexion Redis et notifie l’équipe en cas de bascule prolongée.
Un mécanisme de repli qui fonctionne sans jamais prévenir personne finit toujours par se transformer en dette technique invisible.
En résumé
La panne aurait pu interrompre la campagne d’adhésions d’un syndicat professionnel en plein pic d’activité. Le mécanisme de repli vers le cache de transients, correctement implémenté et testé en amont, a permis de traverser l’incident sans interruption perceptible côté visiteurs. Ce billet ne traite volontairement pas de la mise en place d’une haute disponibilité complète pour Redis lui-même, qui reste un sujet d’infrastructure distinct.