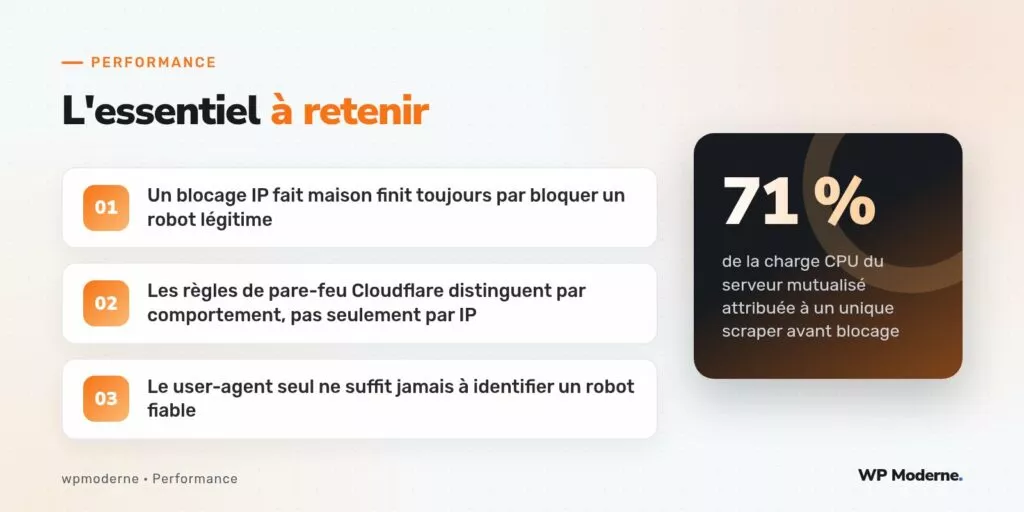
71 % de la charge CPU d’un serveur mutualisé, attribuée à un seul et même visiteur non humain : c’est le chiffre qui a déclenché l’intervention sur ce projet, un site hébergé sur un mutualisé partagé avec plusieurs autres sites du même client, tous ralentis par un scraper qui parcourait systématiquement chaque page du catalogue, plusieurs fois par jour, sans respecter le fichier robots.txt ni marquer de délai entre ses requêtes.
La première réaction, presque réflexe, aurait consisté à bloquer l’adresse IP incriminée directement dans le fichier .htaccess du serveur. Cette approche a été écartée d’emblée : un blocage IP fait à la main risque à tout moment de bloquer, par erreur, un robot légitime dont l’adresse change ou se confond avec celle d’un service partagé, ou pire, de bloquer Googlebot lui-même si l’IP identifiée appartient en réalité à une plage partagée par plusieurs services.
1. Vérifier l’identité déclarée avant de blâmer le comportement
Avant toute action, chaque robot suspect doit être identifié précisément : son user-agent déclaré, et surtout la vérification que l’adresse IP d’origine correspond bien aux plages officiellement publiées par le service qu’il prétend représenter. Un user-agent affichant « Googlebot » ne garantit rien en soi : n’importe quel scraper peut usurper cette chaîne de caractères. La vérification fiable passe par une résolution DNS inversée suivie d’une résolution directe, une méthode documentée officiellement par Google pour confirmer qu’une requête provient bien de ses infrastructures.
2. Distinguer les robots légitimes à préserver absolument
- Googlebot et Bingbot, indispensables au référencement du site, jamais bloqués même en cas de comportement ponctuellement agressif (mieux vaut alors ajuster le crawl-delay recommandé côté Search Console).
- Les robots de Cloudflare lui-même, qui réalisent des vérifications de disponibilité et de sécurité, à ne jamais confondre avec un scraper tiers malveillant.
- Les robots de surveillance légitimes commandités par le client (outils de suivi de disponibilité, robots d’audit SEO commandés explicitement), à documenter dans une liste blanche partagée avec l’équipe.
3. S’appuyer sur les règles de pare-feu Cloudflare plutôt qu’un blocage IP statique
Plutôt qu’un blocage IP fixe, les règles de pare-feu Cloudflare permettent de cibler un comportement plutôt qu’une seule adresse : un taux de requêtes anormalement élevé sur une courte période, combiné à l’absence de cookies de session (signe qu’aucun navigateur réel n’exécute JavaScript) et à un score de bot déjà calculé nativement par Cloudflare selon des heuristiques comportementales.
# Règle de pare-feu Cloudflare (exemple d'expression)
(cf.bot_management.score lt 10) and
(http.request.uri.path contains "/catalogue/") and
not (cf.bot_management.verified_bot)
Cette règle cible spécifiquement les visiteurs au score de bot très faible (donc probablement automatisés) sur les pages du catalogue, tout en excluant explicitement les robots vérifiés par Cloudflare (Googlebot, Bingbot, et les principaux robots légitimes reconnus), ce qui élimine le risque de bloquer par erreur un robot que l’on souhaite justement préserver.
4. Limiter plutôt que bloquer, en première intention
Avant un blocage complet, une règle de limitation de débit (rate limiting) a été appliquée en premier lieu, autorisant un nombre de requêtes raisonnable par minute et par adresse IP avant de renvoyer un code 429, ce qui laisse une chance à un robot mal identifié de continuer à fonctionner à un rythme acceptable plutôt que de le bannir intégralement sur la base d’une identification imparfaite.
5. Documenter et revoir périodiquement
Chaque règle ajoutée a été documentée avec sa date de création, sa justification, et un rappel de révision fixé à six mois, pour éviter l’accumulation de règles obsolètes ou trop restrictives au fil du temps, un piège classique sur les sites où plusieurs personnes interviennent successivement sur la configuration du pare-feu sans visibilité sur les règles déjà en place.
Un blocage IP fait à la main est toujours une solution provisoire qui devient, avec le temps, une source de faux positifs. Les règles comportementales, elles, s’adaptent au visiteur, pas à son adresse du moment.
En résumé
Distinguer un scraper agressif d’un robot légitime sur un hébergement mutualisé partagé ne se résout jamais durablement par un blocage d’adresse IP fait à la main. En s’appuyant sur les règles de pare-feu Cloudflare, capables d’évaluer un score de bot comportemental et de préserver explicitement les robots vérifiés, la charge CPU générée par le scraper identifié est retombée à un niveau négligeable, sans jamais avoir bloqué, même temporairement, Googlebot ou un autre robot légitime nécessaire au site.